Beschleunigt KI ihre eigene Entwicklung? METR-Bericht und die neue Rolle des Menschen in der Forschung
In diesem Artikel
Beschleunigt KI ihre eigene Entwicklung? METR-Bericht und die neue Rolle des Menschen in der Forschung
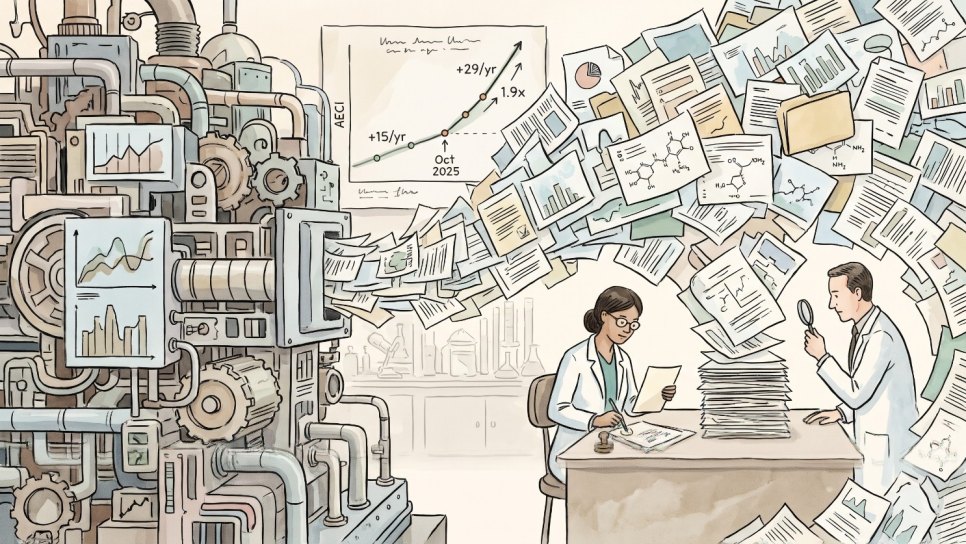
In der Künstlichen Intelligenz gab es lange eine beruhigende Annahme: „Wenn die Probleme schwieriger werden, verlangsamt sich der Fortschritt von selbst.“ Eine Bewertung der unabhängigen Organisation METR (Model Evaluation & Threat Research, Bewertung von Modellen und Erforschung von Bedrohungen), die zwischen August und Oktober 2026 im Inneren von Anthropic durchgeführt und am 5. November 2026 veröffentlicht wurde, schwächt diese Annahme. Laut dem Bericht ist das Tempo, mit dem die Fähigkeiten der Anthropic-Modelle zunehmen, seit Oktober 2025 auf etwa das 1,9-Fache gestiegen, und METR führt den größten Teil dieser Beschleunigung auf den Beitrag der KI zur Forschung zurück. In diesem Beitrag erkläre ich, was der Bericht sagt und was nicht, welche Zeitprognosen sich aus diesen Daten ableiten und was ich für das eigentlich Wichtige halte: Der Engpass in der Wissenschaftsproduktion verschiebt sich, und die Rolle des Menschen wandert vom Erzeugen zum Auswählen und Überprüfen. Den Platz der KI im medizinischen Publizieren habe ich in meinem Beitrag zu den KI-Regeln von JAMA (auf Türkisch) behandelt.
- Was hat der Bericht gefunden? Der kombinierte Fähigkeitsindex der Anthropic-Modelle (AECI) steigt seit Oktober 2025 etwa 1,9-mal so schnell wie zuvor (95 % Konfidenzintervall 1,5-2,8): von rund 15 auf 29 Punkte pro Jahr. METR führt subjektiv etwa 80 % dieser Beschleunigung auf die KI selbst zurück.
- Was hat er nicht gefunden? Die KI kann zu den kritischsten Teilen der Modellentwicklung noch keine vollständig eigenständigen Beiträge leisten. Auch für die nächsten 12 Monate wurde kein überzeugender Engpass gefunden; METR hat in diese Einschätzung allerdings nur geringes Vertrauen.
- Grenzen: Der größte Teil der aussagekräftigsten Belege wurde auf Wunsch des Unternehmens aus Gründen der Vertraulichkeit geschwärzt. Unklar ist, wie sich Testwerte in reale Fähigkeiten übersetzen. Bei den Modellen anderer Unternehmen ist die Beschleunigung geringer (1,4-fach).
- Was das für uns bedeutet: Die Richtung zählt, nicht ein genaues Datum. Je leichter der Zugang zu Informationen wird, desto entscheidender werden die richtige Frage zu wählen, Ergebnisse kritisch zu prüfen und verantwortungsvoll anzuwenden. In der Medizin bleibt die klinische Validierung ein eigener, langsamer Engpass.
Warum ist dieses Thema wichtig?
KI dringt inzwischen in alle Bereiche der Medizin vor, von der Diagnose über die Therapiewahl bis zur Arzneimittelentwicklung und zum wissenschaftlichen Publizieren (der AACR-Bericht 2026 und KI, KI, die das Ansprechen auf Immuntherapie vorhersagt; beide auf Türkisch). Wie schnell sich diese Werkzeuge entwickeln, beeinflusst direkt, wie Ärzte, Forschende und Institutionen die nächsten Jahre planen.
Bisher wurde der größte Teil des Tempos mit mehr Rechenleistung und mehr Daten erklärt. Neu am METR-Bericht ist die Aussage, dass der Fortschritt inzwischen teilweise vom eigenen Beitrag der KI zur Forschung gespeist wird. Ein besseres Modell bedeutet also schnellere Forschung, und diese wiederum ein besseres Modell. Ob dieser Kreislauf real ist und wie stark er ist, wird auch jenseits der Technologiewelt mitbestimmen, wie Wissenschaft künftig betrieben wird.
Was sagt der METR-Bericht?
Der METR-Bericht schätzt, dass das Tempo des Fähigkeitszuwachses der Anthropic-Modelle nach Oktober 2025 auf etwa das 1,9-Fache gestiegen ist und dass ein großer Teil dieser Beschleunigung aus dem Beitrag der KI zur Forschung stammt. Die KI führt die Forschung noch nicht vollständig eigenständig; ihr Beitrag ist überwiegend unterstützend.
METR bewertete die Beschleunigung anhand mehrerer Quellen: ein Fähigkeitsindex, der interne und externe Tests des Unternehmens kombiniert (AECI), interne Messungen zu Vortraining, bestärkendem Lernen und Rechenleistung, Gespräche mit etwa 15 Mitarbeitenden, von den Mitarbeitenden selbst berichtete Produktivitätsgewinne sowie Daten wie Codezeilen und Nutzungsausgaben. Der auffälligste Befund im Diagramm: Der jährliche Anstieg des Fähigkeitsindex stieg von etwa 15 auf 29 Punkte; im letzten Jahr geschah so viel wie sonst in etwa zwei Jahren der früheren Periode. METR ist sicher, dass sich diese Beschleunigung nicht durch die gestiegene Rechenleistung im Training erklären lässt.
Jährlicher Anstieg des Fähigkeitsindex
Anthropic-Modelle, AECI (kombinierter Wert aus internen und externen Tests); Punkte pro Jahr.
In einem Jahr etwa so viel Fortschritt wie früher in rund zwei Jahren. Die Beschleunigung lässt sich nicht durch die gestiegene Trainings-Rechenleistung erklären. Wie sich die Indexwerte in reale Fähigkeiten übersetzen, ist unklar.
Wie belastbar ist die Schätzung?
METR schreibt offen, dass das Ergebnis empfindlich auf Analyseentscheidungen reagiert. Ändern sich die Annahmen zur Schwierigkeit der Tests, zur Berechnung des Trends und zur Auswahl der Tests, schwankt die Schätzung der Beschleunigung zwischen dem 1,1- und dem 2,9-Fachen. Die für die Spitzenmodelle anderer Unternehmen berechnete Beschleunigung ist niedriger, etwa das 1,4-Fache. Da das fortschrittlichste interne Modell bei allen 15 verwendeten Tests über 50 % erreichte, wird die Messung mit den bestehenden Tests zudem immer schwieriger.
Wie belastbar ist die Schätzung der Beschleunigung?
Verhältnis des Zuwachstempos nach Oktober 2025 zu dem davor; 1 = keine Beschleunigung.
Schwierigkeit der Tests, Berechnung des Trends und Auswahl der Tests verändern das Ergebnis. Da das fortschrittlichste interne Modell bei allen 15 Tests über 50 % erreichte, wird die Messung immer schwieriger.
Die Gespräche zeichnen ein ähnliches Bild. Von den 11 eingeordneten Gesprächen gingen 5 davon aus, dass sich der Fortschritt um mehr als das Doppelte beschleunigt hat, 4 waren grenzwertig oder unklar, 2 verneinten. Der von den Mitarbeitenden selbst berichtete Produktivitätsgewinn erreichte beim leistungsfähigsten internen Modell bis zum 12-Fachen; METR bezeichnet das jedoch als „sehr lockeren Beleg“. Dass selbst berichtete Produktivität in die Irre führen kann, hatte die Entwicklerstudie von METR aus dem Jahr 2025 klar gezeigt.
Einschätzungen der Forschenden
Die 11 von METR befragten Anthropic-Mitarbeitenden; Antwort auf die Frage „Hat sich der Fortschritt um mehr als das Doppelte beschleunigt?“, Anzahl der Personen.
Der von den Mitarbeitenden selbst berichtete Produktivitätsgewinn erreichte beim leistungsfähigsten internen Modell bis zum 12-Fachen; METR bezeichnet das als „sehr lockeren Beleg“. Die KI kann zu den wichtigsten Teilen des Modelltrainings noch keine vollständig eigenständigen Beiträge leisten, es gibt aber „Lebenszeichen“.
Was der Bericht nicht sagt
- Die KI führt die Forschung nicht allein. Laut METR kann die KI zu den wichtigsten Teilen der Modellentwicklung noch keine vollständig eigenständigen Beiträge leisten; ihr Beitrag ist überwiegend unterstützend.
- Ein wichtiger Teil der Belege ist nicht sichtbar. Das Unternehmen nutzte sein Recht, Informationen zu schwärzen, die es als wettbewerbsrelevant einstufte. METR selbst stellt fest, dass die Öffentlichkeit weitgehend auf sein Urteil vertrauen muss und der Bericht keine Transparenz der Belege herstellen konnte.
- Ein Testwert ist nicht die reale Welt. Unklar ist, wie sich Zuwächse in Tests in reale Fähigkeiten übersetzen. Der Bericht merkt auch an, dass die Konzentration auf klar definierte, überprüfbare Aufgaben die Beschleunigung überzeichnen kann.
- Nur ein Unternehmen. Die Bewertung wurde nur bei Anthropic durchgeführt; bei den Modellen anderer Unternehmen erscheint die Beschleunigung geringer.
Diese Grenzen mindern den Wert des Berichts nicht, verlangen aber ein aufmerksames Lesen. Wie ich es auch in Gesundheitsmeldungen oft sehe, sind ein eindrucksvolles Diagramm und ein belastbarer Beleg nicht dasselbe (scheinbar solide Studien, evidenzbasierte Medizin; beide auf Türkisch).
Warum hat die Annahme „Probleme werden schwieriger, also verlangsamt sich der Fortschritt“ an Gewicht verloren?
Jonathan Mann, der Autor, der den Bericht einordnet, schreibt, er habe früher gehofft, die zunehmende Schwierigkeit werde die Beschleunigung bremsen, denke aber nicht mehr so. Nach seiner Lesart wird der Fortschritt tatsächlich schwieriger, aber nicht im erwarteten Tempo. Steigende Investitionen und der Forschungsbeitrag von Modellen, die mit jeder Generation leistungsfähiger werden, gleichen die normalerweise zu erwartende Verlangsamung mehr als aus. Der METR-Bericht sagt ebenfalls, dass er für die nächsten 12 Monate kein deutliches Anzeichen abnehmender Erträge sieht und dass dies das Risiko einer sich aufschaukelnden Beschleunigung birgt.
Abbildung 1 · Bremse und Gaspedal
Schwierigere Probleme und schnellere Forschung
Zeitprognosen: eine Richtung, keine Gewissheit
Auf Grundlage dieses Bildes verschiebt Jonathan Mann seine mediane Schätzung für KI auf transformativem Niveau (TAI) auf Mitte 2029, etwa ein Jahr früher als seine Schätzung vor einem Jahr. Die Wahrscheinlichkeit, dieses Niveau durch einen plötzlichen Durchbruch deutlich früher, schon im nächsten Jahr, zu erreichen, beziffert er auf etwa eins zu sechs. Wird diese Wahrscheinlichkeit einbezogen, rückt der Median auf Mitte 2028. Berücksichtigt er jedoch auch bremsende Faktoren wie Regulierung, Störungen der Chip-Versorgung oder den Bedarf an einem neuen Ansatz, bleibt sein Gesamtmedian bei Mitte 2029.
Nach der Rechnung des Autors muss sich das Maß des „Zeithorizonts“ von METR (die Dauer der Aufgaben, die KI eigenständig bewältigen kann) für dieses Niveau 6- bis 12-mal verdoppeln. Dauert jede Verdopplung anfangs etwa 4 Monate und wird diese Dauer mit der Zeit kürzer, entspricht das einem Fenster von 2 bis 4 Jahren. Das ist kürzer als der strategische Planungszyklus der meisten Institutionen und als die Dauer einer Doktorarbeit.
Abbildung 2 · Das Fenster von 2 bis 4 Jahren
Eine grobe Rechnung und bremsende Faktoren
Beim Lesen dieser Prognosen sollte man zwei Dinge im Kopf behalten. Erstens ist die Prognose die Deutung eines einzelnen Autors, die auf öffentlich zugänglichen Daten und Eindrücken aus der Branche beruht; sie ist keine Gewissheit. Zweitens betrug die Verdopplungszeit des Zeithorizonts in der ersten METR-Studie von 2025 etwa 7 Monate; die 4 Monate spiegeln einen neueren, schnelleren Trend wider, und es gibt keine Garantie, dass dieser Trend anhält. Dennoch ist kein starker Grund erkennbar, die Richtung zu ändern.
Der Engpass verschiebt sich
Die knappe Ressource in der Wissenschaftsproduktion ändert sich. KI kann die gesamte vorhandene Literatur durchsuchen, Hypothesen erzeugen und Tausende von Analysen und Experimenten parallel durchführen. Die Aufmerksamkeit der menschlichen Forschenden dagegen bleibt begrenzt. Mit Jonathan Manns Worten gehen die ergiebigsten Forschungsideen schneller zur Neige, als neue entstehen; die leicht zu erntenden Früchte sind weg, und Fortschritte müssen zunehmend aus marginaleren Quellen kommen. Doch die Kapazität der Maschinenintelligenz zum Durchsuchen und Ausprobieren ist groß genug, um diese Marginalität auszugleichen.
Die praktische Bedeutung: Die Rolle des Menschen in der Forschung wandert vom Erzeugen zum Auswählen und Überprüfen. Welche Frage lohnt sich? Welches Ergebnis ist verlässlich? Welcher Befund sollte in die reale Welt überführt werden? Diese Entscheidungen werden zum wichtigsten menschlichen Element, das das Tempo des Fortschritts bestimmt. Die meisten großen Entdeckungen der Geschichte begannen ohnehin damit, die richtige Frage zu stellen (Aziz Sancar und die DNA-Reparatur, der Nobelpreis für Medizin 2026; beide auf Türkisch).
Abbildung 3 · Arbeitsteilung in der Forschung
Vom Erzeugen zum Auswählen und Überprüfen
Was bedeutet das für Medizin und Onkologie?
Dieses Bild zeigt sich auch in der Medizin. KI beginnt, aus einer einzigen Blutprobe mehrere Krankheiten zu erkennen, auf Bildern übersehene Befunde aufzuspüren und aus großen Genomdaten Therapieziele abzuleiten (viele Krankheiten aus einer Blutprobe, KI in der Koloskopie, proteogenomische Karte; alle auf Türkisch). Die Arbeit, für die das Humangenomprojekt 13 Jahre brauchte, ist heute in Tagen möglich; die Aktivität Tausender Gene aus einer einzigen Blutprobe zu lesen und in eine Therapieentscheidung zu übersetzen, hängt inzwischen weitgehend von Rechenleistung ab (das Humangenomprojekt, der Vollblut-Transkriptom-Atlas, das umsetzbare Transkriptom; alle auf Türkisch). KI macht es auch möglich, aus Routinebildern neue biologische Informationen zu gewinnen (braunes Fett im PET-CT, auf Türkisch). Je schneller Hypothesenbildung und Datenanalyse werden, desto mehr besteht der eigentliche Beitrag einer Onkologin, eines Onkologen oder einer Forschenden darin, die richtige Frage zu stellen und die entstehenden Befunde kritisch zu prüfen.
In der Medizin gibt es jedoch einen weiteren Engpass, den die KI-Forschung nicht hat: die klinische Validierung. Um zu zeigen, dass ein Arzneimittel Patienten tatsächlich zu einem längeren und besseren Leben verhilft, braucht es freiwillige Patienten, einen stufenweisen Prozess, der mit ersten Studien am Menschen beginnt, jahrelange Nachbeobachtung und eine sorgfältige Sicherheitsbewertung (was ist eine Phase-1-Studie?, auf Türkisch). KI kann eine Hypothese an einem Tag erzeugen, das Gesamtüberleben aber nicht an einem Tag messen. Man sollte daran denken, dass sich viele plausibel erscheinende Hypothesen in großen klinischen Studien nicht bestätigt haben (eine Endpunktstudie mit negativem Ergebnis, was ist eine klinische Studie?; beide auf Türkisch). Deshalb wird die Beschleunigung in der Medizin weniger vom Labor als vom Design klinischer Studien, von der Patientenauswahl und von der richtigen Interpretation der Daten abhängen.
Auch die Beziehung zwischen Patient und Arzt verändert sich. Meine Patienten kommen inzwischen mit Fragen in die Sprechstunde, die sie mit KI vorbereitet haben; das ist keine Bedrohung, sondern, gut gehandhabt, eine Chance (wenn der Patient mit KI kommt, auf Türkisch). Versuche, die KI bis zum Ausstellen von Rezepten gehen zu lassen, rücken Fragen der Verantwortung und Sicherheit in den Vordergrund (das KI-Rezeptpilotprojekt in Utah, auf Türkisch).
Gründe zur Vorsicht
- Testwerte sind nicht die reale Welt. Ein Modell, das in Tests gut abschneidet, zeigt bei komplexen und unklaren Aufgaben der realen Welt womöglich nicht denselben Erfolg.
- Selbst berichtete Produktivität kann täuschen. In der randomisierten Studie von METR aus dem Jahr 2025 hielten sich Entwickler für schneller, waren tatsächlich aber langsamer.
- Ein Teil der Belege ist vertraulich. Auch wenn die Bewertung unabhängig ist, sind die aussagekräftigsten Daten nicht öffentlich.
- Äußere Faktoren. Regulierung, Chip-Versorgung, Energie und der Bedarf an einem neuen Ansatz können den Zeitplan verlängern.
- In schnell wachsenden Feldern ist das Risiko der Übertreibung hoch. In der Wissenschaft sind Beispiele nicht selten, in denen Übertreibung und Werbung den Belegen vorauseilten (Übertreibung und Wirklichkeit in der Wissenschaft, auf Türkisch).
Fragen, die wir uns stellen sollten
- Hat meine Institution oder mein Team geplant, wie KI in den nächsten 2-4 Jahren die Forschungs- und klinische Arbeitslast verändern wird?
- Mit welcher Methode überprüfe ich ein mit KI erzeugtes Ergebnis?
- Vermittle ich meinen Studierenden und Assistenten Wissen, oder lehre ich sie, die richtige Frage zu stellen und kritisch zu denken?
- Sind Regeln bereit, die Patientendaten und Patientensicherheit schützen?
- Wer entscheidet mit welchen Belegen, einen Befund in die Klinik zu überführen?
- „KI verbessert sich jetzt selbst.“ Nicht ganz. Laut METR ist ihr Beitrag überwiegend unterstützend; bei den kritischsten Aufgaben ist sie nicht vollständig eigenständig.
- „Transformative KI kommt 2029 ganz sicher.“ Nein. Das ist die probabilistische Median-Schätzung eines einzelnen Autors; sie kann früher oder später eintreten.
- „Die gemessene Beschleunigung gilt für die gesamte KI-Branche.“ Die Bewertung wurde bei einem einzigen Unternehmen durchgeführt; bei den Modellen anderer Unternehmen erscheint die Beschleunigung geringer.
- „KI wird Ärzte und Forschende überflüssig machen.“ Ihre Rolle wird sich ändern: Auswählen, Überprüfen und Verantwortung übernehmen werden wichtiger als Erzeugen.
- „KI wird in der Medizin auch alles im gleichen Tempo beschleunigen.“ Klinische Validierung braucht Patienten, Zeit und Sicherheit; dieser Engpass verschwindet nicht von selbst.
Häufig gestellte Fragen
- Was sagt der METR-Bericht?
- Nach der unabhängigen Bewertung, die METR im November 2026 veröffentlichte, stieg das Tempo des Fähigkeitszuwachses der Anthropic-Modelle nach Oktober 2025 auf etwa das 1,9-Fache (95 % Konfidenzintervall 1,5-2,8). METR führt den größten Teil dieser Beschleunigung auf den Beitrag der KI zur Forschung zurück, stellt aber fest, dass die KI die Forschung noch nicht vollständig eigenständig führt.
- Wann wird transformative KI erwartet?
- In Jonathan Manns Deutung auf Grundlage des METR-Berichts liegt die mediane Schätzung bei Mitte 2029, etwa ein Jahr früher als seine Schätzung vor einem Jahr. Wird die Wahrscheinlichkeit eines plötzlichen Durchbruchs einbezogen, rückt Mitte 2028 in den Vordergrund. Diese Schätzungen sind Wahrscheinlichkeiten, keine Gewissheiten, und können sich durch Faktoren wie Regulierung oder Chip-Versorgung ändern.
- Wie verändert KI die wissenschaftliche Forschung?
- KI übernimmt rasch Aufgaben wie Literatursuche, Hypothesenbildung, Datenanalyse und die Durchführung von Experimenten. Deshalb wandert die Rolle des Menschen vom Erzeugen zum Auswählen und Überprüfen: Die richtige Frage zu wählen, Ergebnisse kritisch zu prüfen und Befunde verantwortungsvoll in die reale Welt zu überführen, rückt in den Vordergrund.
- Wie wirkt sich diese Beschleunigung auf die Medizin aus?
- Beschleunigungen werden bei Diagnostik, Bildgebung, Genomanalyse und Wirkstoffentwicklung erwartet. Um jedoch zu zeigen, dass eine Behandlung Patienten tatsächlich nützt, sind klinische Studien, jahrelange Nachbeobachtung und eine Sicherheitsbewertung nötig. Dieser Engpass behält seine Bedeutung, egal wie stark sich die KI beschleunigt.
Glossar
- METR
- Forschungsorganisation, die die Fähigkeiten und Risiken von KI-Modellen unabhängig bewertet.
- AECI
- Fähigkeitsindex, der interne und externe Tests von Anthropic kombiniert; eine Anpassung des Epoch Capabilities Index.
- F&E-Automatisierung
- Die Erledigung eines Teils der Forschungs- und Entwicklungsarbeit durch KI.
- Zeithorizont
- Die Dauer von Aufgaben, gemessen an der Zeit, die ein Mensch bräuchte, die ein KI-Modell mit einer bestimmten Erfolgsquote eigenständig bewältigen kann.
- Verdopplungszeit
- Die Zeit, die vergeht, bis sich ein Maß verdoppelt.
- TAI
- KI auf transformativem Niveau; ein Fähigkeitsniveau, das Wirtschaft und Wissenschaft grundlegend verändern könnte.
- Engpass
- Die knappste Ressource, die das Tempo eines Prozesses begrenzt.
- Abnehmende Erträge
- Der Nutzen, der bei gleichem Aufwand erzielt wird, wird allmählich kleiner.
- Konfidenzintervall
- Schätzbereich, in dem der wahre Wert mit einer bestimmten Wahrscheinlichkeit liegt.
- Klinische Validierung
- Der Nachweis durch klinische Studien, dass eine Diagnose oder Behandlung Patienten einen realen Nutzen bringt.
DROZDOGAN Akademie-Kommentar
Dieser Bericht zeigt eher eine Richtung, als ein Datum zu nennen. Die Entwicklung der KI beschleunigt sich teilweise durch ihren eigenen Beitrag, und diese Beschleunigung wird sich kurzfristig wohl nicht von selbst verlangsamen. Die eigentliche Frage sollte nicht „wann“ lauten, sondern „worauf richten wir unsere Aufmerksamkeit“.
⚡ Warum es wichtig ist
In einer Welt, in der der Zugang zu Informationen nahezu unbegrenzt und billig wird, liegt der Wettbewerbsvorteil nicht im Besitz von Informationen, sondern darin, die richtige Frage zu wählen, Ergebnisse kritisch zu prüfen und verantwortungsvoll anzuwenden.
✅ Stärken
Eine unabhängige Bewertung mit Zugang zu unternehmensinternen Daten; mehrere Belegquellen; offen benannte Unsicherheiten und Grenzen; eine Zahlenschätzung mit Konfidenzintervall.
⚠️ Grenzen
Ein wichtiger Teil der Belege ist geschwärzt; nur ein Unternehmen; die Übertragung von Testwerten auf die reale Welt ist unklar; die Zeitprognosen sind die Deutung eines einzelnen Autors.
🩺 In der Praxis
In meinem Team und bei meinen Studierenden versuche ich, die richtige Frage, das Hinterfragen der Quelle und das Prüfen des Ergebnisses über das Auswendiglernen von Wissen zu stellen. Jeden von KI erzeugten Befund halte ich für verpflichtend durch den Filter der evidenzbasierten Medizin zu schicken, bevor er den Patienten erreicht.
❓ Offene Fragen
Wird sich die Beschleunigung auch bei anderen Unternehmen und in anderen Wissenschaftsbereichen zeigen? In welchem Maß wird sich der Anstieg der Testwerte auf die reale Welt übertragen? Wie werden sich klinische Validierungsprozesse an dieses Tempo anpassen? Wer wird die sichere und gerechte Nutzung dieser Macht wie überwachen?
Fazit: In einer Welt mit Systemen, die fähiger sind als der klügste Mensch, liegt der Vorteil nicht im Zugang zu Informationen, sondern darin, die richtige Frage zu wählen, Ergebnisse kritisch zu prüfen und verantwortungsvoll anzuwenden. Wer diese Kompetenzen heute auf institutioneller und individueller Ebene nicht aufbaut, wird nur die Folgen des Fortschritts beobachten, nicht sein Tempo.
- Dieser Beitrag wurde im November 2026 erstellt.
- Die Angaben zum Bericht beruhen auf der Veröffentlichung von METR vom 5. November 2026. Einige Teile des Berichts wurden auf Wunsch des Unternehmens geschwärzt; METR weist im Bericht offen darauf hin.
- Die Zeitprognosen beruhen auf dem persönlichen Blogbeitrag von Jonathan Mann; sie sind keine offizielle Schätzung einer Institution. Das „Fenster von 2 bis 4 Jahren“ ist eine grobe Rechnung mit den Annahmen dieses Autors.
- Die Diagramme und Schemata im Beitrag sind vereinfacht. Der Akademie-Kommentar ist meine eigene Einschätzung.
Quellen
- METR. Independent assessment of AI R&D acceleration at Anthropic in October 2026 (5 November 2026). metr.org
- METR. Benchmarks provide one piece of evidence for acceleration (X, November 2026). x.com
- Mann J. My read on METR's AI R&D report. Abstraction (November 2026). abstraction.substack.com
- LessWrong. METR: Independent assessment of AI R&D acceleration at Anthropic (discussion). lesswrong.com
War dieser Artikel hilfreich?
Ihre Rückmeldung hilft uns, unsere Inhalte zu verbessern.