აჩქარებს თუ არა ხელოვნური ინტელექტი საკუთარ განვითარებას? METR-ის ანგარიში და ადამიანის როლი
ამ სტატიაში
აჩქარებს თუ არა ხელოვნური ინტელექტი საკუთარ განვითარებას? METR-ის ანგარიში და ადამიანის როლი
ხელოვნური ინტელექტის სფეროში დიდხანს არსებობდა დამამშვიდებელი ვარაუდი: „რაც უფრო რთულდება პრობლემები, პროგრესი თავისთავად ნელდება.“ დამოუკიდებელი შეფასების ორგანიზაციის METR-ის (Model Evaluation & Threat Research, მოდელების შეფასებისა და საფრთხეების კვლევა) შეფასება, რომელიც 2026 წლის აგვისტო-ოქტომბერში Anthropic-ის შიგნით ჩატარდა და 2026 წლის 5 ნოემბერს გამოქვეყნდა, ამ ვარაუდს ასუსტებს. ანგარიშის მიხედვით, Anthropic-ის მოდელების შესაძლებლობების ზრდის ტემპი 2025 წლის ოქტომბრიდან დაახლოებით 1,9-ჯერ გაიზარდა და METR ამ აჩქარების დიდ ნაწილს ხელოვნური ინტელექტის კვლევაში შეტანილ წვლილს მიაწერს. ამ სტატიაში განვმარტავ, რას ამბობს და რას არ ამბობს ანგარიში, რა დროის შეფასებები გამომდინარეობს ამ მონაცემებიდან და რა არის, ჩემი აზრით, ნამდვილად მნიშვნელოვანი: მეცნიერების წარმოებაში ბოთლის ყელი გადაადგილდება და ადამიანის როლი წარმოებიდან შერჩევასა და გადამოწმებაზე გადადის. ხელოვნური ინტელექტის ადგილი სამედიცინო გამოცემებში განვიხილე JAMA-ს ხელოვნური ინტელექტის წესებზე დაწერილ სტატიაში (თურქულად).
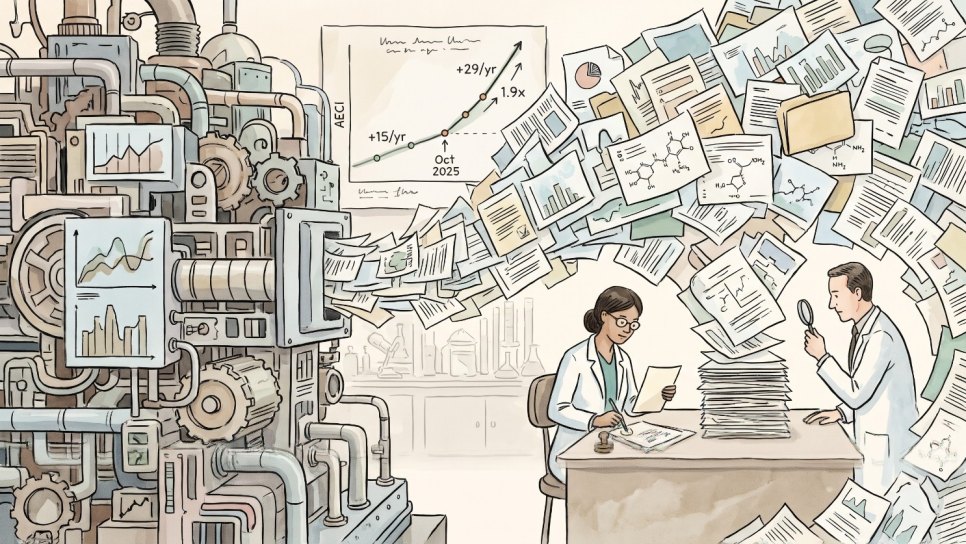
- რა აღმოაჩინა ანგარიშმა? Anthropic-ის მოდელების გაერთიანებული შესაძლებლობების ინდექსი (AECI) 2025 წლის ოქტომბრის შემდეგ ადრინდელზე დაახლოებით 1,9-ჯერ სწრაფად იზრდება (95% ნდობის ინტერვალი 1,5-2,8): წელიწადში დაახლოებით 15 ქულიდან 29 ქულამდე. METR სუბიექტურად ამ აჩქარების დაახლოებით %80-ს თავად ხელოვნურ ინტელექტს მიაწერს.
- რა არ აღმოაჩინა? ხელოვნურ ინტელექტს ჯერ არ შეუძლია სრულიად დამოუკიდებელი წვლილი შეიტანოს მოდელების განვითარების ყველაზე კრიტიკულ ნაწილებში. მომდევნო 12 თვისთვის დამაჯერებელი ბოთლის ყელიც არ აღმოჩნდა; თუმცა METR ამ შეფასებას დაბალი სანდოობით აფასებს.
- შეზღუდვები: ყველაზე ინფორმატიული მტკიცებულებების უმეტესობა კომპანიის მოთხოვნით, კონფიდენციალურობის გამო, დაფარულია. გაურკვეველია, როგორ აისახება ტესტის ქულები რეალურ შესაძლებლობებზე. სხვა კომპანიების მოდელებში აჩქარება უფრო მცირეა (1,4-ჯერ).
- რას ნიშნავს ეს ჩვენთვის: მნიშვნელოვანია მიმართულება და არა ზუსტი თარიღი. რაც უფრო ადვილი ხდება ინფორმაციაზე წვდომა, მით უფრო გადამწყვეტი უნარები ხდება სწორი კითხვის არჩევა, შედეგის კრიტიკული შემოწმება და პასუხისმგებლობით გამოყენება. მედიცინაში კლინიკური ვალიდაცია კვლავ ცალკე და ნელი ბოთლის ყელია.
რატომ არის ეს თემა მნიშვნელოვანი?
ხელოვნური ინტელექტი მედიცინის ყველა სფეროში შედის, დიაგნოსტიკიდან და მკურნალობის არჩევიდან წამლების შემუშავებამდე და სამეცნიერო გამოცემებამდე (AACR 2026-ის ანგარიში და ხელოვნური ინტელექტი, იმუნოთერაპიაზე პასუხის პროგნოზირებადი ხელოვნური ინტელექტი; ორივე თურქულად). ამ ინსტრუმენტების განვითარების სიჩქარე პირდაპირ განსაზღვრავს, როგორ დაგეგმავენ ექიმები, მკვლევრები და დაწესებულებები მომდევნო რამდენიმე წელს.
აქამდე სიჩქარის დიდი ნაწილი მეტი გამოთვლითი სიმძლავრითა და მონაცემებით აიხსნებოდა. METR-ის ანგარიშის ახალი სათქმელი ისაა, რომ პროგრესს ახლა ნაწილობრივ ხელოვნური ინტელექტის საკუთარი წვლილი კვებავს კვლევაში. ანუ უკეთესი მოდელი ნიშნავს უფრო სწრაფ კვლევას, ის კი უკეთეს მოდელს. ეს ციკლი რეალურია თუ არა და რამდენად ძლიერია, განსაზღვრავს, როგორ გაკეთდება მეცნიერება ტექნოლოგიების სამყაროს მიღმაც.
რას ამბობს METR-ის ანგარიში?
METR-ის ანგარიში აფასებს, რომ Anthropic-ის მოდელების შესაძლებლობების ზრდის ტემპი 2025 წლის ოქტომბრის შემდეგ დაახლოებით 1,9-ჯერ გაიზარდა და ამ აჩქარების დიდი ნაწილი ხელოვნური ინტელექტის წვლილით აიხსნება კვლევაში. ხელოვნური ინტელექტი ჯერ კვლევას სრულიად დამოუკიდებლად არ წარმართავს; მისი წვლილი ძირითადად დამხმარე ხასიათისაა.
METR-მა აჩქარება რამდენიმე წყაროთი შეაფასა: შესაძლებლობების ინდექსი, რომელიც კომპანიის შიდა და გარე ტესტებს აერთიანებს (AECI), შიდა გაზომვები წინასწარი წვრთნის, განმტკიცებით სწავლებისა და გამოთვლითი სიმძლავრის შესახებ, ინტერვიუები დაახლოებით 15 თანამშრომელთან, თავად თანამშრომლების მიერ დასახელებული პროდუქტიულობის ზრდა და ისეთი მონაცემები, როგორიცაა კოდის ხაზები და გამოყენების ხარჯები. გრაფიკის ყველაზე თვალშისაცემი აღმოჩენაა, რომ შესაძლებლობების ინდექსის წლიური ზრდა დაახლოებით 15 ქულიდან 29 ქულამდე გაიზარდა: ბოლო ერთ წელიწადში მოხდა წინა პერიოდის დაახლოებით ორი წლის პროგრესი. METR დარწმუნებულია, რომ ეს აჩქარება წვრთნაში გამოყენებული გამოთვლითი სიმძლავრის ზრდით ვერ აიხსნება.
შესაძლებლობების ინდექსის წლიური ზრდა
Anthropic-ის მოდელები, AECI (შიდა და გარე ტესტების გაერთიანებული ქულა); ქულა/წელი.
ერთ წელიწადში წინა პერიოდის დაახლოებით ორი წლის პროგრესი. აჩქარება წვრთნისთვის გამოყენებული გამოთვლითი სიმძლავრის ზრდით არ აიხსნება. გაურკვეველია, როგორ აისახება ინდექსის ქულები რეალური სამყაროს შესაძლებლობებზე.
რამდენად საიმედოა შეფასება?
METR ღიად წერს, რომ შედეგი მგრძნობიარეა ანალიზის არჩევანის მიმართ. როდესაც იცვლება ვარაუდები ტესტების სირთულის, ტრენდის გამოთვლის წესისა და ტესტების არჩევის შესახებ, აჩქარების შეფასება 1,1-დან 2,9-ჯერამდე მერყეობს. სხვა კომპანიების წამყვანი მოდელებისთვის გამოთვლილი აჩქარება უფრო დაბალია, დაახლოებით 1,4-ჯერ. გარდა ამისა, რადგან ყველაზე მოწინავე შიდა მოდელმა გამოყენებული 15 ტესტიდან ყველაში %50-ზე მეტი ქულა მიიღო, არსებული ტესტებით გაზომვა სულ უფრო რთულდება.
რამდენად საიმედოა აჩქარების შეფასება?
2025 წლის ოქტომბრის შემდგომი და წინა ზრდის ტემპის შეფარდება; 1 = აჩქარების გარეშე.
ტესტების სირთულე, ტრენდის გამოთვლის წესი და ტესტების არჩევანი შედეგს ცვლის. რადგან ყველაზე მოწინავე შიდა მოდელმა 15-ვე ტესტში %50-ზე მეტი ქულა მიიღო, გაზომვა სულ უფრო რთულდება.
ინტერვიუებიც მსგავს სურათს ხატავს. კლასიფიცირებული 11 ინტერვიუდან 5 იმას ამბობდა, რომ პროგრესი 2-ჯერ მეტად აჩქარდა, 4 საზღვრულ ან გაურკვეველ მდგომარეობაში იყო, 2 კი უარყოფითად პასუხობდა. თანამშრომლების მიერ დასახელებული პროდუქტიულობის ზრდა ყველაზე უნარიან შიდა მოდელზე 12-ჯერამდე მივიდა; თუმცა METR მას „ძალიან სუსტ მტკიცებულებად“ მიიჩნევს. რომ თვითშეფასებული პროდუქტიულობა შეიძლება შემცდარი იყოს, METR-ის 2025 წლის პროგრამისტების კვლევამ ნათლად აჩვენა.
მკვლევრების შეხედულებები
METR-ის მიერ გამოკითხული 11 Anthropic-ის თანამშრომელი; პასუხი კითხვაზე „აჩქარდა თუ არა პროგრესი 2-ჯერ მეტად?“, ადამიანების რაოდენობა.
თანამშრომლების მიერ დასახელებული პროდუქტიულობის ზრდა ყველაზე უნარიან შიდა მოდელზე 12-ჯერამდე მივიდა; METR მას „ძალიან სუსტ მტკიცებულებად“ მიიჩნევს. ხელოვნურ ინტელექტს ჯერ არ შეუძლია სრულიად დამოუკიდებელი წვლილი შეიტანოს მოდელის წვრთნის ყველაზე მნიშვნელოვან ნაწილებში, თუმცა არის „სიცოცხლის ნიშნები“.
რას არ ამბობს ანგარიში
- ხელოვნური ინტელექტი კვლევას მარტო არ წარმართავს. METR-ის მიხედვით, ხელოვნურ ინტელექტს ჯერ არ შეუძლია სრულიად დამოუკიდებელი წვლილი შეიტანოს მოდელების განვითარების ყველაზე მნიშვნელოვან ნაწილებში; მისი წვლილი ძირითადად დამხმარე ხასიათისაა.
- მტკიცებულებების მნიშვნელოვანი ნაწილი არ ჩანს. კომპანიამ გამოიყენა უფლება, დაეფარა ინფორმაცია, რომელსაც კონკურენციის თვალსაზრისით მგრძნობიარედ მიიჩნევდა. METR თავად აღნიშნავს, რომ საზოგადოებას დიდწილად მისი შეფასების იმედად უწევს ყოფნა და ანგარიშმა მტკიცებულებების გამჭვირვალობა ვერ უზრუნველყო.
- ტესტის ქულა რეალური სამყარო არ არის. გაურკვეველია, როგორ აისახება ტესტებში ზრდა რეალური სამყაროს შესაძლებლობებზე. ანგარიში ასევე აღნიშნავს, რომ კარგად განსაზღვრულ და გადამოწმებად ამოცანებზე ფოკუსირებამ შეიძლება აჩქარება გაზვიადოს.
- მხოლოდ ერთი კომპანია. შეფასება მხოლოდ Anthropic-ში ჩატარდა; სხვა კომპანიების მოდელებში აჩქარება უფრო მცირე ჩანს.
ეს შეზღუდვები ანგარიშის ღირებულებას არ ამცირებს, მაგრამ კითხვისას სიფრთხილეს მოითხოვს. როგორც ჯანდაცვის ამბებშიც ხშირად ვხედავ, თვალშისაცემი გრაფიკი და მყარი მტკიცებულება ერთი და იგივე არ არის (ერთი შეხედვით მყარი კვლევები, მტკიცებულებებზე დაფუძნებული მედიცინა; ორივე თურქულად).
რატომ შესუსტდა ვარაუდი „პრობლემების გართულებასთან ერთად პროგრესი ნელდება“?
ანგარიშის კომენტატორი ავტორი ჯონათან მანი წერს, რომ ადრე იმედოვნებდა, სირთულის ზრდა აჩქარებას შეაფერხებდა, მაგრამ ახლა აღარ ფიქრობს ასე. მისი წაკითხვით, პროგრესი მართლაც რთულდება, მაგრამ არა მოსალოდნელი ტემპით. მზარდი ინვესტიციები და ყოველ თაობაში უფრო უნარიანი მოდელების წვლილი კვლევაში ჩვეულებრივ მოსალოდნელ შენელებას სიჭარბით ანაზღაურებს. METR-ის ანგარიში ასევე აღნიშნავს, რომ მომდევნო 12 თვისთვის კლებადი უკუგების აშკარა ნიშანს ვერ ხედავს და ეს მდგომარეობა დაგროვებადი აჩქარების რისკს შეიცავს.
სურათი 1 · მუხრუჭი და გაზი
რთულდება პრობლემები და ჩქარდება კვლევა
დროის შეფასებები: მიმართულება და არა სიზუსტე
ამ სურათზე დაყრდნობით ჯონათან მანი ტრანსფორმაციული დონის ხელოვნური ინტელექტისთვის (TAI) მედიანურ შეფასებას 2029 წლის შუა პერიოდში აყენებს; ეს ერთი წლით ადრეა მისი ერთი წლის წინანდელი შეფასებისგან. უეცარი გარღვევით ამ დონეს გაცილებით ადრე, მომავალ წელს, მიღწევის ალბათობას დაახლოებით ექვსიდან ერთად აფასებს. ამ ალბათობის გათვალისწინებით მედიანა 2028 წლის შუა პერიოდზე გადადის. თუმცა დამაგვიანებელი ფაქტორების, როგორიცაა რეგულაციები, ჩიპების მიწოდების შეფერხებები ან ახალი მიდგომის საჭიროება, გათვალისწინებით საერთო მედიანას 2029 წლის შუაში ტოვებს.
ავტორის გამოთვლით, ამ დონის მისაღწევად METR-ის „დროითი ჰორიზონტის“ საზომი (ხელოვნური ინტელექტის მიერ დამოუკიდებლად შესრულებადი ამოცანების ხანგრძლივობა) 6-დან 12-ჯერამდე უნდა გაორმაგდეს. თუ თითოეული გაორმაგება თავდაპირველად დაახლოებით 4 თვე გრძელდება და ეს დრო დროთა განმავლობაში მცირდება, ეს 2-დან 4 წლამდე ფანჯარას შეესაბამება. ეს უფრო ხანმოკლეა, ვიდრე უმეტესი დაწესებულების სტრატეგიული დაგეგმვის ციკლი და სადოქტორო ნაშრომის ხანგრძლივობა.
სურათი 2 · 2-დან 4 წლამდე ფანჯარა
უხეში გამოთვლა და დამაგვიანებელი ფაქტორები
ამ შეფასებების კითხვისას ორი რამ უნდა გვახსოვდეს. პირველი, შეფასება ერთი ავტორის ინტერპრეტაციაა, რომელიც ღია მონაცემებსა და დარგის შიგნით შექმნილ შთაბეჭდილებებს ეფუძნება; ეს სიზუსტე არ არის. მეორე, METR-ის 2025 წლის პირველ კვლევაში დროითი ჰორიზონტის გაორმაგების დრო დაახლოებით 7 თვე იყო; 4-თვიანი ვადა უფრო ახალ და უფრო სწრაფ ტრენდს ასახავს და გარანტია არ არის, რომ ეს ტრენდი გაგრძელდება. მიუხედავად ამისა, მიმართულების შეცვლის ძლიერი მიზეზი არ ჩანს.
ბოთლის ყელი გადაადგილდება
მეცნიერების წარმოებაში სიმწირე ცვლის ადგილს. ხელოვნურ ინტელექტს შეუძლია არსებული ლიტერატურის მთლიანად გადასინჯვა, ჰიპოთეზების შექმნა და ათასობით ანალიზისა და ექსპერიმენტის პარალელურად ჩატარება. სამაგიეროდ, ადამიანი მკვლევრის ყურადღება ჯერ კიდევ შეზღუდულია. ჯონათან მანის სიტყვებით, ყველაზე ნაყოფიერი კვლევითი იდეები უფრო სწრაფად იწურება, ვიდრე ახლები იქმნება; ადვილად მისაწვდომი ნაყოფი თავდება და მიღწევები სულ უფრო მარგინალური წყაროებიდან უნდა მოვიდეს. მაგრამ მანქანური ინტელექტის გადასინჯვისა და ცდის შესაძლებლობა იმდენად დიდია, რომ ამ მარგინალურობას აანაზღაურებს.
პრაქტიკული აზრი ასეთია: ადამიანის როლი კვლევაში წარმოებიდან შერჩევასა და გადამოწმებაზე გადადის. რომელი კითხვა ღირს დასმად? რომელი შედეგია სანდო? რომელი აღმოჩენა უნდა გადავიდეს რეალურ სამყაროში? ეს გადაწყვეტილებები პროგრესის ტემპის განმსაზღვრელ ყველაზე მნიშვნელოვან ადამიანურ ელემენტად იქცევა. ისტორიის დიდი აღმოჩენების უმეტესობაც სინამდვილეში სწორი კითხვის დასმით დაიწყო (აზიზ სანჯარი და დნმ-ის შეკეთება, 2026 წლის ნობელის პრემია მედიცინაში; ორივე თურქულად).
სურათი 3 · შრომის განაწილება კვლევაში
წარმოებიდან შერჩევასა და გადამოწმებაზე
რას ნიშნავს ეს მედიცინისა და ონკოლოგიისთვის?
ეს სურათი მედიცინაშიც ჩანს. ხელოვნური ინტელექტი იწყებს რამდენიმე დაავადების ამოცნობას ერთი სისხლის ნიმუშიდან, გამოსახულებებზე გამორჩენილი ნიშნების დაფიქსირებას და მსხვილი გენომური მონაცემებიდან სამკურნალო სამიზნეების ამოღებას (ბევრი დაავადება ერთი სისხლის ნიმუშიდან, ხელოვნური ინტელექტი კოლონოსკოპიაში, პროტეო-გენომური რუკა; ყველა თურქულად). ადამიანის გენომის პროექტის 13 წლიანი სამუშაო დღეს დღეებში არის შესაძლებელი; ერთი სისხლის ნიმუშიდან ათასობით გენის აქტივობის წაკითხვა და სამკურნალო გადაწყვეტილებად გადაქცევა კი ახლა დიდწილად გამოთვლით სიმძლავრეზეა დამოკიდებული (ადამიანის გენომის პროექტი, მთლიანი სისხლის ტრანსკრიპტომის ატლასი, ქმედითი ტრანსკრიპტომი; ყველა თურქულად). ხელოვნური ინტელექტი რუტინული გამოსახულებებიდან ახალი ბიოლოგიური ინფორმაციის ამოღებასაც შესაძლებელს ხდის (ყავისფერი ცხიმი PET-CT-ზე, თურქულად). რაც უფრო ჩქარდება ჰიპოთეზების შექმნა და მონაცემთა ანალიზი, ონკოლოგის ან მკვლევრის ნამდვილი წვლილი სწორი კითხვის დასმა და გამოვლენილი აღმოჩენის კრიტიკული შემოწმება იქნება.
თუმცა მედიცინაში არსებობს კიდევ ერთი ბოთლის ყელი, რომელიც ხელოვნური ინტელექტის კვლევაში არ არის: კლინიკური ვალიდაცია. იმის საჩვენებლად, რომ წამალი მართლაც ეხმარება პაციენტებს უფრო დიდხანს და უკეთ იცხოვრონ, საჭიროა მოხალისე პაციენტები, ეტაპობრივი პროცესი, რომელიც ადამიანზე პირველი კვლევებით იწყება, წლობით მეთვალყურეობა და საფუძვლიანი უსაფრთხოების შეფასება (რა არის პირველი ფაზის კვლევა?, თურქულად). ხელოვნურ ინტელექტს შეუძლია ჰიპოთეზა ერთ დღეში შექმნას, მაგრამ საერთო გადარჩენას ერთ დღეში ვერ გაზომავს. უნდა გვახსოვდეს, რომ ბევრი დამაჯერებლად მოჩვენებული ჰიპოთეზა დიდ კლინიკურ კვლევებში ვერ დადასტურდა (უარყოფითი შედეგის მქონე შედეგობრივი კვლევა, რა არის კლინიკური კვლევა?; ორივე თურქულად). ამიტომ მედიცინაში აჩქარება ლაბორატორიაზე მეტად კლინიკური კვლევის დიზაინზე, პაციენტების შერჩევასა და მონაცემების სწორ ინტერპრეტაციაზე იქნება დამოკიდებული.
პაციენტსა და ექიმს შორის ურთიერთობაც იცვლება. ჩემი პაციენტები ახლა ვიზიტზე ხელოვნური ინტელექტით მომზადებული კითხვებით მოდიან; ეს საფრთხე არ არის, კარგად მართვის შემთხვევაში შესაძლებლობაა (როცა პაციენტი ხელოვნური ინტელექტით მოდის, თურქულად). ხელოვნური ინტელექტის მცდელობები, რეცეპტების წერამდეც კი მივიდეს, პასუხისმგებლობისა და უსაფრთხოების კითხვებს წინა პლანზე წევს (იუტაში ხელოვნური ინტელექტის რეცეპტის პილოტი, თურქულად).
სიფრთხილის მიზეზები
- ტესტის ქულები რეალური სამყარო არ არის. მოდელმა, რომელიც ტესტებში კარგად გამოდის, შეიძლება რთულ და გაურკვეველ რეალურ ამოცანებში იგივე წარმატება ვერ აჩვენოს.
- თვითშეფასებული პროდუქტიულობა შეიძლება შემცდარი იყოს. METR-ის 2025 წლის რანდომიზებულ კვლევაში პროგრამისტები თავს უფრო სწრაფად თვლიდნენ, სინამდვილეში კი უფრო ნელები იყვნენ.
- მტკიცებულებების ნაწილი დაფარულია. შეფასება დამოუკიდებელია, მაგრამ ყველაზე ინფორმატიული მონაცემები საჯარო არ არის.
- გარე ფაქტორები. რეგულაციებმა, ჩიპების მიწოდებამ, ენერგიამ და ახალი მიდგომის საჭიროებამ შეიძლება ვადები გააგრძელოს.
- სწრაფად განვითარებად სფეროებში გაზვიადების რისკი მაღალია. მეცნიერებაში გაზვიადებისა და რეკლამის მტკიცებულებებზე წინ გასვლის მაგალითები არცთუ იშვიათია (გაზვიადება და რეალობა მეცნიერებაში, თურქულად).
კითხვები, რომლებიც საკუთარ თავს უნდა დავუსვათ
- დაგეგმა თუ არა ჩემმა დაწესებულებამ ან გუნდმა, როგორ შეცვლის ხელოვნური ინტელექტი კვლევისა და კლინიკური სამუშაოს დატვირთვას მომდევნო 2-4 წელიწადში?
- რომელი მეთოდით ვამოწმებ ხელოვნური ინტელექტით მიღებულ შედეგს?
- ჩემს სტუდენტებსა და ასისტენტებს ინფორმაციას გადავცემ თუ სწორი კითხვის დასმას და კრიტიკულ აზროვნებას ვასწავლი?
- მზად არის თუ არა წესები, რომლებიც პაციენტის მონაცემებსა და პაციენტის უსაფრთხოებას დაიცავს?
- ვინ და რა მტკიცებულებით იღებს გადაწყვეტილებას, აღმოჩენა კლინიკაში გადაიტანოს?
- „ხელოვნური ინტელექტი უკვე თავად ავითარებს თავს.“ ზუსტად არა. METR-ის მიხედვით, მისი წვლილი ძირითადად დამხმარე ხასიათისაა; ყველაზე კრიტიკულ საქმეებში სრულიად დამოუკიდებელი არ არის.
- „2029 წელს ტრანსფორმაციული ხელოვნური ინტელექტი აუცილებლად მოვა.“ არა. ეს ერთი ავტორის ალბათობაზე დაფუძნებული მედიანური შეფასებაა; შეიძლება უფრო ადრეც მოვიდეს და უფრო გვიანაც.
- „გაზომილი აჩქარება მთელი ხელოვნური ინტელექტის სექტორისთვის მართებულია.“ შეფასება ერთ კომპანიაში ჩატარდა; სხვა კომპანიების მოდელებში აჩქარება უფრო მცირე ჩანს.
- „ხელოვნური ინტელექტი ექიმსა და მკვლევარს აღარ დატოვებს საჭიროებად.“ როლი შეიცვლება: წარმოებაზე მეტად წინა პლანზე შერჩევა, გადამოწმება და პასუხისმგებლობის აღება წამოვა.
- „ხელოვნური ინტელექტი მედიცინაშიც ყველაფერს ერთნაირი სიჩქარით აჩქარებს.“ კლინიკური ვალიდაცია პაციენტს, დროსა და უსაფრთხოებას მოითხოვს; ეს ბოთლის ყელი თავისით არ ქრება.
ხშირად დასმული კითხვები
- რას ამბობს METR-ის ანგარიში?
- METR-ის მიერ 2026 წლის ნოემბერში გამოქვეყნებული დამოუკიდებელი შეფასების მიხედვით, Anthropic-ის მოდელების შესაძლებლობების ზრდის ტემპი 2025 წლის ოქტომბრის შემდეგ დაახლოებით 1,9-ჯერ გაიზარდა (95% ნდობის ინტერვალი 1,5-2,8). METR ამ აჩქარების დიდ ნაწილს ხელოვნური ინტელექტის წვლილით ხსნის კვლევაში, მაგრამ აღნიშნავს, რომ ხელოვნური ინტელექტი ჯერ კვლევას სრულიად დამოუკიდებლად არ წარმართავს.
- როდის არის მოსალოდნელი ტრანსფორმაციული ხელოვნური ინტელექტი?
- ჯონათან მანის ინტერპრეტაციაში METR-ის ანგარიშზე დაყრდნობით, მედიანური შეფასება 2029 წლის შუაა; ეს დაახლოებით ერთი წლით ადრეა მისი ერთი წლის წინანდელი შეფასებისგან. როდესაც უეცარი გარღვევის ალბათობა გათვალისწინებულია, წინა პლანზე 2028 წლის შუა გამოდის. ეს შეფასებები ალბათობაა და არა სიზუსტე და შეიძლება შეიცვალოს ისეთი ფაქტორებით, როგორიცაა რეგულაციები ან ჩიპების მიწოდება.
- როგორ ცვლის ხელოვნური ინტელექტი სამეცნიერო კვლევას?
- ხელოვნური ინტელექტი სწრაფად იღებს ისეთ საქმეებს, როგორიცაა ლიტერატურის გადასინჯვა, ჰიპოთეზების შექმნა, მონაცემთა ანალიზი და ექსპერიმენტების ჩატარება. ამიტომ ადამიანის როლი წარმოებიდან შერჩევასა და გადამოწმებაზე გადადის: წინა პლანზე წამოვა სწორი კითხვის არჩევა, შედეგის კრიტიკული შემოწმება და აღმოჩენის პასუხისმგებლობით გადატანა რეალურ სამყაროში.
- როგორ იმოქმედებს ეს აჩქარება მედიცინაზე?
- აჩქარება მოსალოდნელია დიაგნოსტიკაში, გამოსახულებით კვლევაში, გენომურ ანალიზსა და წამლების აღმოჩენაში. თუმცა იმის საჩვენებლად, რომ მკურნალობა პაციენტს მართლაც ეხმარება, საჭიროა კლინიკური კვლევები, წლობით მეთვალყურეობა და უსაფრთხოების შეფასება. ეს ბოთლის ყელი თავის მნიშვნელობას შეინარჩუნებს, რაც უნდა აჩქარდეს ხელოვნური ინტელექტი.
ლექსიკონი
- METR
- კვლევითი ორგანიზაცია, რომელიც დამოუკიდებლად აფასებს ხელოვნური ინტელექტის მოდელების შესაძლებლობებსა და რისკებს.
- AECI
- შესაძლებლობების ინდექსი, რომელიც აერთიანებს Anthropic-ის შიდა და გარე ტესტებს; Epoch-ის შესაძლებლობების ინდექსის ადაპტაცია.
- კვლევისა და განვითარების ავტომატიზაცია
- კვლევისა და განვითარების სამუშაოს ნაწილის შესრულება ხელოვნური ინტელექტის მიერ.
- დროითი ჰორიზონტი
- იმ ამოცანების ხანგრძლივობა (ადამიანისთვის საჭირო დროით), რომელსაც ხელოვნური ინტელექტის მოდელი დამოუკიდებლად, გარკვეული წარმატების მაჩვენებლით ასრულებს.
- გაორმაგების დრო
- დრო, რომელიც საჭიროა საზომის გასაორმაგებლად.
- TAI
- ტრანსფორმაციული დონის ხელოვნური ინტელექტი; შესაძლებლობების დონე, რომელსაც შეუძლია ეკონომიკისა და მეცნიერების ძირეული შეცვლა.
- ბოთლის ყელი
- ყველაზე მწირი რესურსი, რომელიც პროცესის სიჩქარეს ზღუდავს.
- კლებადი უკუგება
- იმავე ძალისხმევით მიღებული სარგებლის თანდათანობითი შემცირება.
- ნდობის ინტერვალი
- შეფასების დიაპაზონი, რომელშიც ნამდვილი მნიშვნელობა გარკვეული ალბათობით მდებარეობს.
- კლინიკური ვალიდაცია
- კლინიკური კვლევებით ჩვენება, რომ დიაგნოზი ან მკურნალობა პაციენტს რეალურ სარგებელს მოუტანს.
DROZDOGAN აკადემიის კომენტარი
ეს ანგარიში თარიღზე მეტად მიმართულებას აჩვენებს. ხელოვნური ინტელექტის განვითარება ნაწილობრივ საკუთარი წვლილით ჩქარდება და ეს აჩქარება უახლოეს პერიოდში თავისთავად შენელებას არ მოასწავებს. ძირითადი კითხვა „როდის“ კი არა, „რაზე გავამახვილოთ ყურადღება“ უნდა იყოს.
⚡ რატომ არის მნიშვნელოვანი
სამყაროში, სადაც ინფორმაციაზე წვდომა თითქმის შეუზღუდავი და იაფი ხდება, კონკურენტული უპირატესობა ინფორმაციის ფლობაში კი არა, სწორი კითხვის არჩევაში, შედეგის კრიტიკულ შემოწმებასა და პასუხისმგებლობით გამოყენებაში იქნება.
✅ ძლიერი მხარეები
დამოუკიდებელი შეფასება კომპანიის შიდა მონაცემებზე წვდომით; მტკიცებულებების რამდენიმე წყარო; გაურკვევლობებისა და შეზღუდვების ღია აღნიშვნა; ციფრული შეფასება ნდობის ინტერვალით.
⚠️ შეზღუდვები
მტკიცებულებების მნიშვნელოვანი ნაწილი დაფარულია; მხოლოდ ერთი კომპანია; ტესტის ქულების გადატანა რეალურ სამყაროზე გაურკვეველია; დროის შეფასებები ერთი ავტორის ინტერპრეტაციაა.
🩺 პრაქტიკაში
ჩემს გუნდსა და სტუდენტებში ვცდილობ, ინფორმაციის დაზეპირებაზე მეტად სწორი კითხვის დასმა, წყაროს კითხვის ქვეშ დაყენება და შედეგის შემოწმება წინა პლანზე წამოვწიო. ხელოვნური ინტელექტის მიერ შექმნილ ყველა აღმოჩენას, პაციენტამდე მისვლამდე, მტკიცებულებებზე დაფუძნებული მედიცინის ფილტრში გატარებას აუცილებლად მივიჩნევ.
❓ ღია კითხვები
გამოჩნდება თუ არა აჩქარება სხვა კომპანიებში და მეცნიერების სხვა სფეროებში? რამდენად აისახება ტესტის ქულების ზრდა რეალურ სამყაროზე? როგორ შეეგუება კლინიკური ვალიდაციის პროცესები ამ სიჩქარეს? ვინ და როგორ გააკონტროლებს ამ ძალის უსაფრთხო და სამართლიან გამოყენებას?
დასკვნა: სამყაროში, სადაც არსებობს სისტემები, რომლებიც ყველაზე ჭკვიან ადამიანზე უფრო უნარიანია, უპირატესობა ინფორმაციაზე წვდომაში კი არა, სწორი კითხვის არჩევაში, შედეგის კრიტიკულ შემოწმებასა და პასუხისმგებლობით გამოყენებაში იქნება. ვინც ამ კომპეტენციებს დღეს, ინსტიტუციურ და ინდივიდუალურ დონეზე, არ ააშენებს, პროგრესის სიჩქარეს კი არა, მხოლოდ მის შედეგებს დააკვირდება.
- ეს სტატია მომზადებულია 2026 წლის ნოემბერში.
- ანგარიშთან დაკავშირებული ინფორმაცია ეფუძნება METR-ის 2026 წლის 5 ნოემბრის პუბლიკაციას. ანგარიშის ზოგიერთი ნაწილი კომპანიის მოთხოვნით დაფარულია; METR ამას ანგარიშში ღიად აღნიშნავს.
- დროის შეფასებები ეფუძნება ჯონათან მანის პირად ბლოგპოსტს; ისინი რომელიმე დაწესებულების ოფიციალური შეფასება არ არის. „2-დან 4 წლამდე ფანჯარა“ ამ ავტორის ვარაუდებით შესრულებული უხეში გამოთვლაა.
- სტატიაში მოცემული გრაფიკები და სქემები გამარტივებულია. აკადემიის კომენტარი ჩემია.
წყაროები
- METR. Independent assessment of AI R&D acceleration at Anthropic in October 2026 (5 November 2026). metr.org
- METR. Benchmarks provide one piece of evidence for acceleration (X, November 2026). x.com
- Mann J. My read on METR's AI R&D report. Abstraction (November 2026). abstraction.substack.com
- LessWrong. METR: Independent assessment of AI R&D acceleration at Anthropic (discussion). lesswrong.com
ეს სტატია სასარგებლო იყო თქვენთვის?
თქვენი გამოხმაურება გვეხმარება შინაარსის გაუმჯობესებაში.