آیا هوش مصنوعی توسعه خود را شتاب میدهد؟ گزارش METR و نقش در حال تغییر انسان در علم
در این مقاله
آیا هوش مصنوعی توسعه خود را شتاب میدهد؟ گزارش METR و نقش در حال تغییر انسان در علم
در حوزه هوش مصنوعی مدتها یک فرض آرامشبخش وجود داشت: «هرچه مسائل دشوارتر شوند، پیشرفت خودبهخود کند میشود.» ارزیابی سازمان مستقل METR (Model Evaluation & Threat Research؛ ارزیابی مدل و پژوهش تهدید) که بین اوت و اکتبر 2026 درون شرکت Anthropic انجام شد و در 5 نوامبر 2026 منتشر شد، این فرض را تضعیف میکند. بر پایه گزارش، نرخ افزایش توانایی مدلهای Anthropic از اکتبر 2025 تاکنون حدود 1٫9 برابر شده است و METR بخش بزرگی از این شتاب را به سهم خود هوش مصنوعی در پژوهش نسبت میدهد. در این مقاله توضیح میدهم گزارش چه میگوید و چه نمیگوید، چه برآوردهای زمانی از این دادهها بیرون میآید و به نظر من موضوع اصلی چیست: گلوگاه تولید علم جابهجا میشود و نقش انسان از تولید کردن به انتخاب کردن و راستیآزمایی تغییر میکند. جایگاه هوش مصنوعی در انتشار پزشکی را در مقاله من درباره قوانین هوش مصنوعی JAMA (به ترکی) بررسی کرده بودم.
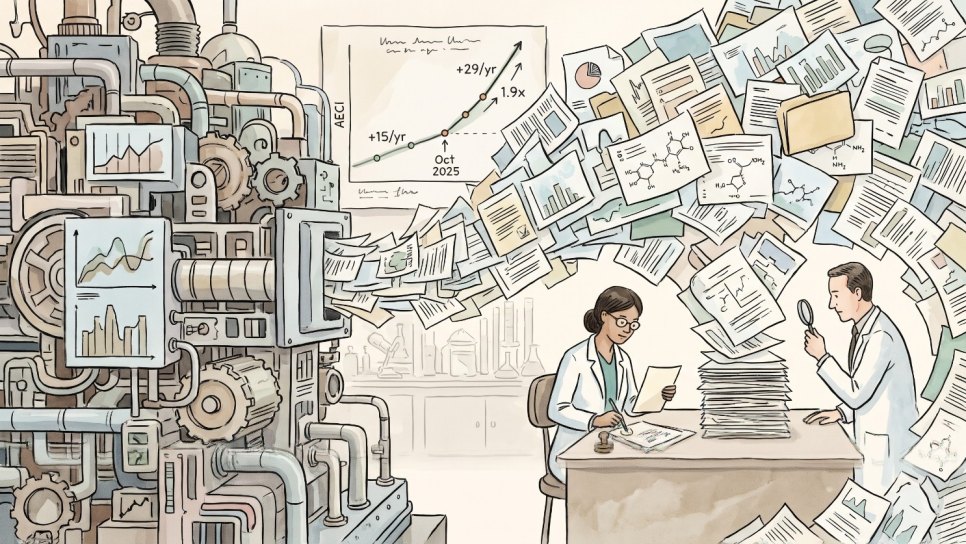
- گزارش چه یافت؟ شاخص ترکیبی توانایی مدلهای Anthropic (AECI) پس از اکتبر 2025 حدود 1٫9 برابر سریعتر از قبل افزایش مییابد (فاصله اطمینان 95 درصد: 1٫5-2٫8): از حدود 15 به 29 امتیاز در سال. METR بهصورت ذهنی حدود 80 درصد این شتاب را به خود هوش مصنوعی نسبت میدهد.
- چه چیزی نیافت؟ هوش مصنوعی هنوز نمیتواند در بحرانیترین بخشهای توسعه مدل سهمی کاملاً مستقل داشته باشد. برای 12 ماه آینده نیز گلوگاه قانعکنندهای پیدا نشد؛ اما METR به این ارزیابی اطمینان کمی دارد.
- محدودیتها: بیشتر آموزندهترین شواهد به درخواست شرکت و به دلیل محرمانگی پنهان شد. روشن نیست امتیازهای آزمونها چگونه به توانایی در دنیای واقعی تبدیل میشوند. در مدلهای شرکتهای دیگر شتاب کمتر است (1٫4 برابر).
- معنای آن برای ما: جهت اهمیت دارد، نه تاریخ دقیق. هرچه دسترسی به اطلاعات آسانتر میشود، انتخاب پرسش درست، آزمودن انتقادی نتیجه و بهکارگیری مسئولانه آن به مهارتهای تعیینکننده تبدیل میشود. در پزشکی، اعتبارسنجی بالینی همچنان گلوگاهی جدا و کند است.
چرا این موضوع مهم است؟
هوش مصنوعی اکنون به همه حوزههای پزشکی وارد میشود، از تشخیص و انتخاب درمان تا توسعه دارو و انتشار علمی (گزارش AACR 2026 و هوش مصنوعی، هوش مصنوعی پیشبینیکننده پاسخ به ایمونوتراپی؛ هر دو به ترکی). سرعت پیشرفت این ابزارها مستقیماً بر چگونگی برنامهریزی پزشکان، پژوهشگران و نهادها برای چند سال آینده اثر میگذارد.
تا امروز بخش بزرگی از سرعت با توان محاسباتی و داده بیشتر توضیح داده میشد. نکته تازه گزارش METR این است که پیشرفت اکنون تا حدی از سهم خود هوش مصنوعی در پژوهش تغذیه میشود. یعنی مدل بهتر، پژوهش سریعتر و آن هم مدل بهتر. واقعی بودن این چرخه و قدرت آن، فراتر از دنیای فناوری، نحوه انجام علم را نیز تعیین خواهد کرد.
گزارش METR چه میگوید؟
گزارش METR برآورد میکند نرخ افزایش توانایی مدلهای Anthropic پس از اکتبر 2025 حدود 1٫9 برابر شده و بخش بزرگ این شتاب از سهم هوش مصنوعی در پژوهش ناشی میشود. هوش مصنوعی هنوز پژوهش را کاملاً مستقل پیش نمیبرد؛ سهم آن بیشتر جنبه کمکی دارد.
METR شتاب را از چند منبع مختلف ارزیابی کرد: شاخص توانایی که آزمونهای داخلی و بیرونی شرکت را ترکیب میکند (AECI)، اندازهگیریهای داخلی درباره پیشآموزش، یادگیری تقویتی و توان محاسباتی، مصاحبه با حدود 15 کارمند، افزایش بهرهوری که خود کارکنان گزارش کردهاند و دادههایی مانند تعداد خطوط کد و هزینه استفاده. چشمگیرترین یافته نمودار این است که افزایش سالانه شاخص توانایی از حدود 15 امتیاز به 29 امتیاز رسیده است: در یک سال اخیر، حدود دو سال پیشرفت دوره پیشین رخ داد. METR مطمئن است که این شتاب با افزایش توان محاسباتی مصرفشده در آموزش توضیح داده نمیشود.
افزایش سالانه در شاخص توانایی
مدلهای Anthropic، AECI (امتیاز ترکیبی آزمونهای داخلی و بیرونی)؛ امتیاز در سال.
در یک سال، حدود دو سال پیشرفت دوره پیشین. شتاب با افزایش توان محاسباتی مصرفشده در آموزش توضیح داده نمیشود. روشن نیست امتیازهای شاخص چگونه به تواناییهای دنیای واقعی تبدیل میشوند.
برآورد چقدر استوار است؟
METR آشکارا مینویسد که نتیجه به انتخابهای تحلیلی حساس است. وقتی فرضها درباره دشواری آزمونها، شیوه محاسبه روند و انتخاب آزمونها تغییر میکند، برآورد شتاب بین 1٫1 تا 2٫9 برابر نوسان میکند. شتاب محاسبهشده برای مدلهای پیشرو شرکتهای دیگر کمتر است، حدود 1٫4 برابر. افزون بر این، چون پیشرفتهترین مدل داخلی در هر 15 آزمون بهکاررفته امتیازی بالاتر از 50 درصد گرفته است، اندازهگیری با آزمونهای موجود روزبهروز دشوارتر میشود.
برآورد شتاب چقدر استوار است؟
نسبت نرخ افزایش پس از اکتبر 2025 به پیش از آن؛ 1 = بدون شتاب.
دشواری آزمونها، شیوه محاسبه روند و انتخاب آزمونها نتیجه را تغییر میدهد. چون پیشرفتهترین مدل داخلی در هر 15 آزمون امتیازی بالاتر از 50 درصد گرفته است، اندازهگیری روزبهروز دشوارتر میشود.
مصاحبهها نیز تصویری مشابه میکشند. از 11 مصاحبه طبقهبندیشده، 5 مورد میگفتند پیشرفت بیش از 2 برابر شتاب گرفته، 4 مورد مرزی یا نامطمئن بود و 2 مورد پاسخ منفی داشت. افزایش بهرهوری که خود کارکنان گزارش کردند در توانمندترین مدل داخلی تا 12 برابر رسید؛ اما METR آن را «شواهدی بسیار سست» میداند. اینکه بهرهوری خودگزارششده میتواند گمراهکننده باشد را مطالعه METR در 2025 درباره برنامهنویسان بهروشنی نشان داده بود.
دیدگاه پژوهشگران
11 کارمند Anthropic که METR با آنها مصاحبه کرد؛ پاسخ به پرسش «آیا پیشرفت بیش از 2 برابر شتاب گرفته است؟»، تعداد نفر.
افزایش بهرهوری که خود کارکنان گزارش کردند در توانمندترین مدل داخلی تا 12 برابر رسید؛ METR آن را «شواهدی بسیار سست» میداند. هوش مصنوعی هنوز نمیتواند در مهمترین بخشهای آموزش مدل سهمی کاملاً مستقل داشته باشد، اما «نشانههای حیات» دیده میشود.
آنچه گزارش نمیگوید
- هوش مصنوعی پژوهش را بهتنهایی پیش نمیبرد. به گفته METR، هوش مصنوعی هنوز نمیتواند در مهمترین بخشهای توسعه مدل سهمی کاملاً مستقل داشته باشد؛ سهم آن بیشتر جنبه کمکی دارد.
- بخش مهمی از شواهد دیده نمیشود. شرکت از حق خود برای پنهان کردن اطلاعاتی که از نظر رقابتی حساس میدانست استفاده کرد. METR خود میگوید مردم ناچارند تا حد زیادی به داوری او اعتماد کنند و گزارش نتوانسته شفافیت شواهد را تأمین کند.
- امتیاز آزمون، دنیای واقعی نیست. روشن نیست افزایش در آزمونها چگونه به تواناییهای دنیای واقعی تبدیل میشود. گزارش همچنین یادآوری میکند تمرکز بر وظایف تعریفشده و راستیآزماییپذیر میتواند شتاب را بیش از واقع نشان دهد.
- فقط یک شرکت. ارزیابی تنها در Anthropic انجام شد؛ در مدلهای شرکتهای دیگر شتاب کمتر دیده میشود.
این محدودیتها از ارزش گزارش نمیکاهند؛ اما هنگام خواندن باید دقت کرد. همانطور که در خبرهای سلامت هم بارها دیدهام، یک نمودار چشمگیر با شواهد استوار یکسان نیست (پژوهشهای ظاهراً استوار، پزشکی مبتنی بر شواهد؛ هر دو به ترکی).
چرا فرض «مسائل که دشوارتر شوند، پیشرفت کند میشود» تضعیف شد؟
نویسندهای که گزارش را تفسیر میکند، Jonathan Mann، مینویسد پیشتر امیدوار بود افزایش دشواری مانع شتاب شود، اما دیگر چنین فکر نمیکند. به خوانش او، پیشرفت واقعاً دشوارتر میشود، اما نه با سرعت مورد انتظار. سرمایهگذاری فزاینده و سهم مدلهایی که در هر نسل تواناتر میشوند در پژوهش، کندیای را که بهطور عادی رخ میداد با اضافه جبران میکند. گزارش METR نیز میگوید برای 12 ماه آینده نشانه روشنی از بازده کاهنده نمیبیند و این وضعیت خطر شتابی انباشته و فزاینده را به همراه دارد.
شکل 1 · ترمز و گاز
مسائل دشوارتر و پژوهش سریعتر
برآوردهای زمانی: جهت، نه قطعیت
Jonathan Mann بر پایه این تصویر برآورد میانه خود را برای هوش مصنوعی در سطح دگرگونساز (TAI) به اواسط 2029 میکشد؛ این حدود یک سال زودتر از برآورد یک سال پیش اوست. او احتمال رسیدن به این سطح بسیار زودتر، سال آینده و با یک جهش ناگهانی، را حدود یک ششم میداند. با در نظر گرفتن این احتمال، میانه به اواسط 2028 میرود. اما با درنظرگرفتن عوامل تأخیری مانند مقررات، اختلال در تأمین تراشه یا نیاز به رویکردی تازه، میانه کلی خود را در اواسط 2029 نگه میدارد.
به حساب نویسنده، برای رسیدن به این سطح، معیار «افق زمانی» METR (مدت وظایفی که هوش مصنوعی میتواند مستقل انجام دهد) باید 6 تا 12 بار دو برابر شود. اگر هر دو برابر شدن در آغاز حدود 4 ماه طول بکشد و این مدت به مرور کوتاهتر شود، این معادل پنجرهای 2 تا 4 ساله است. این مدت از چرخه برنامهریزی راهبردی بیشتر نهادها و از مدت یک رساله دکتری کوتاهتر است.
شکل 2 · پنجره 2 تا 4 ساله
یک محاسبه تقریبی و عوامل تأخیری
هنگام خواندن این برآوردها باید دو نکته را در نظر داشت. نخست اینکه برآورد، تفسیر یک نویسنده است که بر دادههای عمومی و برداشتهای درون صنعت تکیه دارد؛ قطعیت نیست. دوم اینکه در نخستین مطالعه METR در 2025 زمان دو برابر شدن افق زمانی حدود 7 ماه بود؛ مدت 4 ماهه روندی تازهتر و سریعتر را نشان میدهد و تضمینی نیست این روند ادامه یابد. با این حال دلیل قوی برای تغییر جهت دیده نمیشود.
گلوگاه جابهجا میشود
منبع کمیاب در تولید علم در حال تغییر است. هوش مصنوعی میتواند کل ادبیات موجود را مرور کند، فرضیه تولید کند و هزاران تحلیل و آزمایش را موازی اجرا کند. در مقابل، توجه پژوهشگر انسانی همچنان محدود است. به تعبیر Jonathan Mann، مولدترین ایدههای پژوهشی سریعتر از تولید ایدههای تازه تمام میشوند؛ میوههای دمدست تمام میشود و دستاوردها باید از منابع هرچه حاشیهایتر بیایند. اما ظرفیت مرور و آزمودن هوش ماشینی آنقدر بزرگ است که این حاشیهای بودن را جبران کند.
معنای عملی این است: نقش انسان در پژوهش از تولید کردن به انتخاب کردن و راستیآزمایی تغییر میکند. کدام پرسش ارزش پرسیدن دارد؟ کدام نتیجه قابل اعتماد است؟ کدام یافته باید به دنیای واقعی منتقل شود؟ این تصمیمها به مهمترین عنصر انسانی تعیینکننده سرعت پیشرفت تبدیل میشوند. بیشتر اکتشافات بزرگ تاریخ نیز در واقع با پرسیدن پرسش درست آغاز شد (Aziz Sancar و ترمیم DNA، جایزه نوبل پزشکی 2026؛ هر دو به ترکی).
شکل 3 · تقسیم کار در پژوهش
از تولید کردن تا انتخاب کردن و راستیآزمایی
برای پزشکی و انکولوژی چه معنایی دارد؟
این تصویر در پزشکی هم خود را نشان میدهد. هوش مصنوعی از یک نمونه خون چند بیماری را تشخیص میدهد، یافتههای ازدسترفته در تصاویر را میگیرد و از دادههای بزرگ ژنومی اهداف درمانی بیرون میکشد (چند بیماری از یک نمونه خون، هوش مصنوعی در کولونوسکوپی، نقشه پروتئو-ژنومی؛ همه به ترکی). کاری که پروژه ژنوم انسان در 13 سال انجام داد امروز در چند روز شدنی است؛ خواندن فعالیت هزاران ژن از یک نمونه خون و تبدیل آن به تصمیم درمانی نیز اکنون عمدتاً به توان محاسباتی بسته است (پروژه ژنوم انسان، اطلس ترنسکریپتوم کل خون، ترنسکریپتوم قابل اقدام؛ همه به ترکی). هوش مصنوعی استخراج اطلاعات زیستی تازه از تصاویر روتین را نیز ممکن میکند (چربی قهوهای در PET-CT، به ترکی). با تندتر شدن تولید فرضیه و تحلیل داده، سهم اصلی یک انکولوژیست یا پژوهشگر پرسیدن پرسش درست و آزمودن انتقادی یافتههای پدیدآمده خواهد بود.
اما در پزشکی گلوگاه دیگری هست که در پژوهش هوش مصنوعی نیست: اعتبارسنجی بالینی. برای نشان دادن اینکه یک دارو واقعاً به بیماران کمک میکند طولانیتر و بهتر زندگی کنند، به بیماران داوطلب، فرایندی مرحلهای که از نخستین مطالعات انسانی آغاز میشود، سالها پیگیری و ارزیابی دقیق ایمنی نیاز است (مطالعه فاز 1 چیست؟، به ترکی). هوش مصنوعی میتواند یک فرضیه را در یک روز تولید کند، اما نمیتواند بقای کلی را در یک روز اندازه بگیرد. باید به یاد داشت که بسیاری از فرضیههای بهظاهر موجه در کارآزماییهای بالینی بزرگ تأیید نشدهاند (یک کارآزمایی پیامد با نتیجه منفی، کارآزمایی بالینی چیست؟؛ هر دو به ترکی). به همین دلیل در پزشکی شتاب بیش از آزمایشگاه به طراحی کارآزمایی بالینی، انتخاب بیمار و تفسیر درست داده بستگی خواهد داشت.
رابطه بیمار و پزشک نیز تغییر میکند. بیماران من اکنون با پرسشهایی که با هوش مصنوعی آماده کردهاند به ویزیت میآیند؛ این تهدید نیست و اگر خوب مدیریت شود فرصت است (وقتی بیمار با هوش مصنوعی میآید، به ترکی). تلاشها برای واداشتن هوش مصنوعی حتی به نوشتن نسخه، پرسشهای مسئولیت و ایمنی را پیش میکشد (طرح آزمایشی نسخهنویسی با هوش مصنوعی در یوتا، به ترکی).
دلایل احتیاط
- امتیاز آزمونها دنیای واقعی نیست. مدلی که در آزمونها خوب عمل میکند ممکن است در وظایف پیچیده و مبهم دنیای واقعی همان موفقیت را نشان ندهد.
- بهرهوری خودگزارششده میتواند گمراهکننده باشد. در مطالعه تصادفیسازیشده METR در 2025، برنامهنویسان خود را سریعتر میپنداشتند در حالی که در واقع کندتر بودند.
- بخشی از شواهد پنهان است. هرچند ارزیابی مستقل است، آموزندهترین دادهها عمومی نیستند.
- عوامل بیرونی. مقررات، تأمین تراشه، انرژی و نیاز به رویکردی تازه میتواند زمانبندی را طولانیتر کند.
- در حوزههای بهسرعت در حال رشد خطر اغراق بالاست. در علم نمونههایی که اغراق و تبلیغ بر شواهد پیشی گرفتهاند کم نیستند (اغراق و واقعیت در علم، به ترکی).
پرسشهایی که باید از خود بپرسیم
- آیا نهاد یا تیم من برنامهریزی کرده که هوش مصنوعی در 2 تا 4 سال آینده بار کار پژوهشی و بالینی را چگونه تغییر میدهد؟
- نتیجهای را که با هوش مصنوعی تولید شده با چه روشی راستیآزمایی میکنم؟
- آیا به دانشجویان و دستیارانم اطلاعات منتقل میکنم، یا پرسیدن پرسش درست و تفکر انتقادی را آموزش میدهم؟
- آیا قوانین حفاظت از داده و ایمنی بیمار آماده است؟
- چه کسی و با چه شواهدی تصمیم میگیرد یک یافته را به بالین ببرد؟
- «هوش مصنوعی اکنون خودش را بهتر میکند.» دقیقاً نه. به گفته METR سهم آن بیشتر جنبه کمکی دارد؛ در بحرانیترین کارها کاملاً مستقل نیست.
- «هوش مصنوعی دگرگونساز قطعاً در 2029 میرسد.» خیر. این برآورد میانه احتمالاتی یک نویسنده است؛ ممکن است زودتر یا دیرتر باشد.
- «شتاب اندازهگیریشده برای کل صنعت هوش مصنوعی صادق است.» ارزیابی در یک شرکت انجام شد؛ در مدلهای شرکتهای دیگر شتاب کمتر دیده میشود.
- «هوش مصنوعی نیازی به پزشک و پژوهشگر باقی نمیگذارد.» نقش آنها تغییر خواهد کرد: انتخاب کردن، راستیآزمایی و مسئولیتپذیری بیش از تولید کردن اهمیت مییابد.
- «هوش مصنوعی در پزشکی هم همهچیز را با همان سرعت شتاب میدهد.» اعتبارسنجی بالینی به بیمار، زمان و ایمنی نیاز دارد؛ این گلوگاه خودبهخود از میان نمیرود.
پرسشهای متداول
- گزارش METR چه میگوید؟
- بر پایه ارزیابی مستقلی که METR در نوامبر 2026 منتشر کرد، نرخ افزایش توانایی مدلهای Anthropic پس از اکتبر 2025 حدود 1٫9 برابر شد (فاصله اطمینان 95 درصد: 1٫5-2٫8). METR بخش بزرگ این شتاب را به سهم هوش مصنوعی در پژوهش نسبت میدهد، اما میگوید هوش مصنوعی هنوز پژوهش را کاملاً مستقل پیش نمیبرد.
- هوش مصنوعی دگرگونساز چه زمانی انتظار میرود؟
- در تفسیر Jonathan Mann بر پایه گزارش METR، برآورد میانه اواسط 2029 است؛ این حدود یک سال زودتر از برآورد یک سال پیش اوست. وقتی احتمال یک جهش ناگهانی در نظر گرفته شود، اواسط 2028 پیش میآید. این برآوردها احتمالاند، نه قطعیت، و با عواملی مانند مقررات یا تأمین تراشه میتوانند تغییر کنند.
- هوش مصنوعی پژوهش علمی را چگونه تغییر میدهد؟
- هوش مصنوعی بهسرعت کارهایی مانند مرور ادبیات، تولید فرضیه، تحلیل داده و اجرای آزمایش را بر عهده میگیرد. از این رو نقش انسان از تولید کردن به انتخاب کردن و راستیآزمایی تغییر میکند: انتخاب پرسش درست، آزمودن انتقادی نتیجه و انتقال مسئولانه یافته به دنیای واقعی برجسته میشود.
- این شتاب بر پزشکی چه تأثیری خواهد داشت؟
- در تشخیص، تصویربرداری، تحلیل ژنومی و کشف دارو شتاب انتظار میرود. اما برای نشان دادن اینکه یک درمان واقعاً برای بیمار سودمند است، کارآزماییهای بالینی، سالها پیگیری و ارزیابی ایمنی لازم است. این گلوگاه، هرچقدر هوش مصنوعی شتاب بگیرد، اهمیت خود را حفظ خواهد کرد.
واژهنامه
- METR
- سازمان پژوهشی که بهصورت مستقل تواناییها و خطرهای مدلهای هوش مصنوعی را ارزیابی میکند.
- AECI
- شاخص توانایی که آزمونهای داخلی و بیرونی Anthropic را ترکیب میکند؛ اقتباسی از شاخص توانایی Epoch.
- خودکارسازی پژوهش و توسعه
- انجام بخشی از کارهای پژوهش و توسعه توسط هوش مصنوعی.
- افق زمانی
- مدت وظایفی (بر حسب زمان لازم برای یک انسان) که یک مدل هوش مصنوعی میتواند با نرخ موفقیت مشخص و مستقل انجام دهد.
- زمان دو برابر شدن
- مدت لازم برای دو برابر شدن یک معیار.
- TAI
- هوش مصنوعی در سطح دگرگونساز؛ سطحی از توانایی که میتواند اقتصاد و علم را از پایه تغییر دهد.
- گلوگاه
- کمیابترین منبعی که سرعت یک فرایند را محدود میکند.
- بازده کاهنده
- کوچکتر شدن تدریجی سودی که در برابر همان تلاش به دست میآید.
- فاصله اطمینان
- بازه برآوردی که مقدار واقعی با احتمالی معین در آن قرار دارد.
- اعتبارسنجی بالینی
- نشان دادن اینکه یک تشخیص یا درمان در بیمار سود واقعی دارد، از راه مطالعات بالینی.
تفسیر آکادمی DROZDOGAN
این گزارش بیش از آنکه تاریخی بدهد، جهتی نشان میدهد. توسعه هوش مصنوعی تا حدی با سهم خودش شتاب میگیرد و به نظر نمیرسد این شتاب در کوتاهمدت خودبهخود کند شود. پرسش اصلی «چه زمانی» نیست، باید «توجه خود را به چه چیزی بدهیم» باشد.
⚡ چرا مهم است
در دنیایی که دسترسی به اطلاعات تقریباً نامحدود و ارزان شده، مزیت رقابتی در داشتن اطلاعات نیست، بلکه در انتخاب پرسش درست، آزمودن انتقادی نتیجه و بهکارگیری مسئولانه آن خواهد بود.
✅ نقاط قوت
ارزیابی مستقل با دسترسی به دادههای درون شرکت؛ چند منبع شواهد؛ بیان آشکار عدمقطعیتها و محدودیتها؛ برآورد عددی همراه با فاصله اطمینان.
⚠️ محدودیتها
بخش مهمی از شواهد پنهان شده است؛ فقط یک شرکت؛ روشن نیست امتیاز آزمونها چگونه به دنیای واقعی تبدیل میشود؛ برآوردهای زمانی تفسیر یک نویسنده است.
🩺 در عمل
در تیم و میان دانشجویانم میکوشم بهجای حفظ کردن اطلاعات، پرسیدن پرسش درست، پرسش از منبع و آزمودن نتیجه را برجسته کنم. هر یافتهای را که هوش مصنوعی تولید میکند، پیش از رسیدن به بیمار، لازم میدانم از صافی پزشکی مبتنی بر شواهد بگذرانم.
❓ پرسشهای باز
آیا شتاب در شرکتهای دیگر و حوزههای دیگر علم هم دیده خواهد شد؟ افزایش امتیاز آزمونها تا چه اندازه به دنیای واقعی منتقل میشود؟ فرایندهای اعتبارسنجی بالینی چگونه با این سرعت سازگار میشوند؟ چه کسی و چگونه بر استفاده ایمن و عادلانه از این قدرت نظارت خواهد کرد؟
نتیجه: در دنیایی که سیستمهایی تواناتر از باهوشترین انسان وجود دارد، مزیت در دسترسی به اطلاعات نیست، بلکه در انتخاب پرسش درست، آزمودن انتقادی نتیجه و بهکارگیری مسئولانه آن است. کسانی که امروز این شایستگیها را در سطح نهادی و فردی نمیسازند، تنها پیامدهای پیشرفت را تماشا خواهند کرد، نه سرعت آن را.
- این مقاله در نوامبر 2026 تهیه شده است.
- اطلاعات مربوط به گزارش بر پایه انتشار METR در 5 نوامبر 2026 است. بخشهایی از گزارش به درخواست شرکت پنهان شده است؛ METR این را در گزارش آشکارا ذکر میکند.
- برآوردهای زمانی بر پایه نوشته شخصی وبلاگ Jonathan Mann است؛ برآورد رسمی هیچ نهادی نیست. «پنجره 2 تا 4 ساله» محاسبهای تقریبی با فرضهای همین نویسنده است.
- نمودارها و طرحهای مقاله سادهسازی شدهاند. تفسیر آکادمی از آن من است.
منابع
- METR. Independent assessment of AI R&D acceleration at Anthropic in October 2026 (5 November 2026). metr.org
- METR. Benchmarks provide one piece of evidence for acceleration (X, November 2026). x.com
- Mann J. My read on METR's AI R&D report. Abstraction (November 2026). abstraction.substack.com
- LessWrong. METR: Independent assessment of AI R&D acceleration at Anthropic (discussion). lesswrong.com
آیا این مقاله برای شما مفید بود؟
بازخورد شما به بهبود محتوای ما کمک میکند.