Yapay Zekâda İlerleme Neden Yavaşlamıyor? Darboğaz Yer Değiştiriyor: Bilimde İnsanın Yeni Rolü
Bu Makalede
Yapay Zekâ Kendi Gelişimini Hızlandırıyor mu? METR Raporu ve Bilimde İnsanın Değişen Rolü
Yapay zekâ alanında uzun süre rahatlatıcı bir varsayım vardı: "Problemler zorlaştıkça ilerleme kendiliğinden yavaşlar." Bağımsız değerlendirme kuruluşu METR'in (Model Evaluation & Threat Research, Model Değerlendirme ve Tehdit Araştırması) Ağustos-Ekim 2026 arasında Anthropic'in içinde yürüttüğü ve 5 Kasım 2026'da yayımladığı değerlendirme, bu varsayımı zayıflatıyor. Rapora göre Anthropic modellerinin yetenek artış hızı Ekim 2025'ten bu yana yaklaşık 1,9 katına çıktı ve METR bu hızlanmanın büyük kısmını yapay zekânın araştırmaya katkısına bağlıyor. Bu yazıda raporun ne söylediğini ve ne söylemediğini, bu verilerden yola çıkan zaman tahminlerini ve bence asıl önemli olan konuyu anlatıyorum: Bilim üretiminde darboğaz yer değiştiriyor ve insanın rolü üretmekten seçmeye ve doğrulamaya kayıyor. Yapay zekânın tıbbi yayıncılıktaki yerini JAMA'nın yapay zekâ kuralları yazımda ele almıştım.
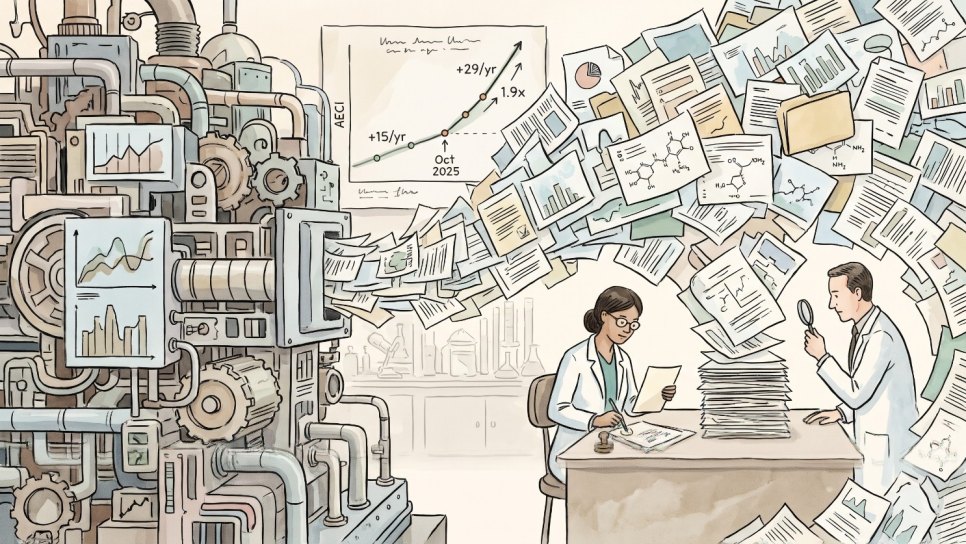
- Rapor ne buldu? Anthropic modellerinin birleşik yetenek endeksi (AECI), Ekim 2025'ten sonra öncekinin yaklaşık 1,9 katı hızla artıyor (%95 GA 1,5-2,8): yılda yaklaşık 15 puandan 29 puana. METR, bu hızlanmanın öznel olarak yaklaşık %80'ini yapay zekânın kendisine bağlıyor.
- Ne bulmadı? Yapay zekâ henüz model geliştirmenin en kritik kısımlarına tam bağımsız katkı yapamıyor. Önümüzdeki 12 ay için ikna edici bir darboğaz da bulunmadı; ancak METR bu değerlendirmeye düşük güven duyuyor.
- Sınırlar: En bilgilendirici kanıtların çoğu şirketin gizlilik talebiyle karartıldı. Test puanlarının gerçek dünyadaki yeteneğe nasıl yansıdığı belirsiz. Başka şirketlerin modellerinde hızlanma daha az (1,4 kat).
- Bizim için anlamı: Kesin tarih değil yön önemli. Bilgiye erişim kolaylaştıkça, doğru soruyu seçmek, sonucu eleştirel olarak sınamak ve sorumlulukla uygulamak belirleyici beceriler hâline geliyor. Tıpta ise klinik doğrulama ayrı ve yavaş bir darboğaz olarak kalıyor.
Bu konu neden önemli?
Yapay zekâ artık tıpta tanıdan tedavi seçimine, ilaç geliştirmeden bilimsel yayıncılığa kadar her alana giriyor (AACR 2026 raporu ve yapay zekâ, immünoterapi yanıtını öngören yapay zekâ). Bu araçların ne kadar hızlı geliştiği, hekimlerin, araştırmacıların ve kurumların önümüzdeki birkaç yılı nasıl planlayacağını doğrudan etkiliyor.
Bugüne kadar hızın büyük kısmı daha fazla işlem gücü ve veriyle açıklanıyordu. METR raporunun yeni söylediği şey, ilerlemenin artık kısmen yapay zekânın kendi araştırmaya katkısıyla beslendiği. Yani daha iyi model, daha hızlı araştırma, o da daha iyi model demek. Bu döngünün gerçek olup olmadığı ve ne kadar güçlü olduğu, teknoloji dünyasının ötesinde bilimin nasıl yapılacağını da belirleyecek.
METR raporu ne söylüyor?
METR raporu, Anthropic modellerinin yetenek artış hızının Ekim 2025'ten sonra yaklaşık 1,9 katına çıktığını ve bu hızlanmanın büyük kısmının yapay zekânın araştırmaya katkısından kaynaklandığını tahmin ediyor. Yapay zekâ henüz araştırmayı tam bağımsız yürütmüyor; katkısı büyük ölçüde yardımcı nitelikte.
METR, hızlanmayı birkaç farklı kaynaktan değerlendirdi: şirketin iç ve dış testlerini birleştiren yetenek endeksi (AECI), ön eğitim, pekiştirmeli öğrenme ve işlem gücüne ilişkin iç ölçümler, yaklaşık 15 çalışanla görüşmeler, çalışanların kendi bildirdiği verimlilik artışları ve kod satırı ile kullanım harcaması gibi veriler. Grafikteki en çarpıcı bulgu, yetenek endeksindeki yıllık artışın yaklaşık 15 puandan 29 puana çıkması: Son bir yılda, önceki dönemin yaklaşık iki yıllık ilerlemesi gerçekleşti. METR, bu hızlanmanın eğitimde kullanılan işlem gücündeki artışla açıklanamayacağından emin.
Yetenek endeksinde yıllık artış
Anthropic modelleri, AECI (iç ve dış testlerin birleşik puanı); puan/yıl.
Bir yılda, önceki dönemin yaklaşık iki yıllık ilerlemesi. Hızlanma, eğitim için kullanılan işlem gücündeki artışla açıklanamıyor. Endeksteki puanların gerçek dünyadaki yeteneklere nasıl yansıdığı belirsizdir.
Tahmin ne kadar sağlam?
METR, sonucun analiz tercihlerine duyarlı olduğunu açıkça yazıyor. Testlerin zorluğuna ilişkin varsayımlar, eğilimin nasıl hesaplandığı ve hangi testlerin seçildiği değiştiğinde hızlanma tahmini 1,1 ile 2,9 kat arasında oynuyor. Başka şirketlerin öncü modelleri için hesaplanan hızlanma ise daha düşük, yaklaşık 1,4 kat. Ayrıca en gelişmiş iç model kullanılan 15 testin hepsinde %50'nin üzerinde puan aldığı için, mevcut testlerle ölçüm giderek zorlaşıyor.
Hızlanma tahmini ne kadar sağlam?
Ekim 2025 sonrası ve öncesi artış hızının oranı; 1 = hızlanma yok.
Testlerin zorluğu, eğilimin nasıl hesaplandığı ve hangi testlerin seçildiği sonucu değiştiriyor. En gelişmiş iç model 15 testin hepsinde %50'nin üzerinde puan aldığı için ölçüm giderek zorlaşıyor.
Görüşmeler de benzer bir tablo çiziyor. Sınıflandırılan 11 görüşmenin 5'i ilerlemenin 2 kattan fazla hızlandığı yönündeydi, 4'ü sınırda ya da belirsizdi, 2'si ise hayır diyordu. Çalışanların kendi bildirdiği verimlilik artışı en yetenekli iç modelde 12 kata kadar çıktı; ancak METR bunu "çok gevşek kanıt" olarak niteliyor. Kendi kendine bildirilen verimliliğin yanıltıcı olabileceğini, METR'in 2025'teki yazılımcı çalışması açıkça göstermişti.
Araştırmacıların görüşleri
METR'in görüştüğü 11 Anthropic çalışanı; "ilerleme 2 kattan fazla hızlandı mı?" sorusuna yanıt, kişi.
Çalışanların kendi bildirdiği verimlilik artışı en yetenekli iç modelde 12 kata kadar çıktı; METR bunu "çok gevşek kanıt" olarak niteliyor. Yapay zekâ henüz model eğitiminin en önemli kısımlarına tam bağımsız katkı yapamıyor, ancak "yaşam belirtileri" var.
Raporun söylemediği şeyler
- Yapay zekâ araştırmayı tek başına yürütmüyor. METR'e göre yapay zekâ henüz model geliştirmenin en önemli kısımlarına tam bağımsız katkı yapamıyor; katkısı büyük ölçüde yardımcı nitelikte.
- Kanıtların önemli kısmı görünmüyor. Şirket, rekabet açısından hassas bulduğu bilgileri karartma hakkını kullandı. METR, kamuoyunun büyük ölçüde kendi yargısına güvenmek zorunda kaldığını ve raporun kanıt şeffaflığını sağlayamadığını kendisi belirtiyor.
- Test puanı gerçek dünya değil. Testlerdeki artışın gerçek dünyadaki yeteneklere nasıl yansıdığı belirsiz. Rapor, iyi tanımlanmış ve doğrulanabilir görevlere odaklanmanın hızlanmayı abartabileceğini de not ediyor.
- Tek bir şirket. Değerlendirme yalnızca Anthropic'te yapıldı; başka şirketlerin modellerinde hızlanma daha az görünüyor.
Bu sınırlar raporun değerini azaltmıyor; ama okurken dikkatli olmayı gerektiriyor. Sağlık haberlerinde de sık gördüğüm gibi, çarpıcı bir grafik ile sağlam bir kanıt aynı şey değildir (görünüşte sağlam araştırmalar, kanıta dayalı tıp).
"Problemler zorlaştıkça yavaşlar" varsayımı neden zayıfladı?
Raporu yorumlayan yazar Jonathan Mann, daha önce zorluğun artmasının hızlanmayı engelleyeceğini umduğunu, ama artık böyle düşünmediğini yazıyor. Onun okumasına göre ilerleme gerçekten zorlaşıyor, fakat beklenen hızda değil. Artan yatırım ve her kuşakta daha yetenekli hâle gelen modellerin araştırmaya katkısı, normalde yaşanacak yavaşlamayı fazlasıyla karşılıyor. METR raporu da önümüzdeki 12 ay için belirgin bir azalan getiri işareti görmediğini ve bu durumun birikerek artan bir hızlanma riski taşıdığını belirtiyor.
Şekil 1 · Fren ve gaz
Zorlaşan problemler ve hızlanan araştırma
Zaman tahminleri: kesinlik değil, yön
Jonathan Mann bu tabloya dayanarak dönüştürücü düzeydeki yapay zekâ (TEDAI) için ortanca tahminini 2029'un ortasına çekiyor; bu, bir yıl önceki tahmininden yaklaşık bir yıl erken. Ani bir atılımla bu düzeye çok daha erken, gelecek yıl ulaşılması olasılığını yaklaşık altıda bir olarak veriyor. Bu olasılık hesaba katıldığında ortanca tahmin 2028 ortasına kayıyor. Ancak düzenlemeler, çip tedarikindeki aksaklıklar ya da yeni bir yaklaşım gerekmesi gibi geciktirici etkenleri de hesaba katarak genel ortanca tahminini 2029 ortasında tutuyor.
Yazarın hesabına göre bu düzeye ulaşmak için, METR'in "zaman ufku" ölçüsünün (yapay zekânın bağımsız tamamlayabildiği görevlerin süresi) 6 ila 12 kez ikiye katlanması gerekiyor. Her katlanma başlangıçta yaklaşık 4 ay sürüyor ve bu süre zamanla kısalıyorsa, bu 2 ila 4 yıllık bir pencereye denk geliyor. Bu süre, çoğu kurumun stratejik planlama döngüsünden ve bir doktora tezinin süresinden kısa.
Şekil 2 · 2 ila 4 yıllık pencere
Kaba bir hesap ve geciktirici etkenler
Bu tahminleri okurken iki şeyi akılda tutmak gerekiyor. Birincisi, tahmin tek bir yazarın, kamuya açık veriler ve sektör içi izlenimlere dayanan yorumudur; bir kesinlik değil. İkincisi, METR'in 2025'teki ilk çalışmasında zaman ufkunun katlanma süresi yaklaşık 7 aydı; 4 aylık süre daha yeni ve daha hızlı bir eğilimi yansıtıyor ve bu eğilimin süreceği garanti değil. Yine de yönü değiştirmek için güçlü bir neden görünmüyor.
Darboğaz yer değiştiriyor
Bilim üretiminde kıt kaynak değişiyor. Yapay zekâ mevcut literatürün tamamını tarayabiliyor, hipotez üretebiliyor, binlerce analizi ve deneyi paralel yürütebiliyor. Buna karşılık insan araştırmacının dikkati hâlâ sınırlı. Jonathan Mann'ın ifadesiyle en verimli araştırma fikirleri, yenileri üretildiğinden daha hızlı tükeniyor; kolay toplanan meyveler bitiyor ve kazanımlar giderek daha marjinal kaynaklardan gelmek zorunda kalıyor. Ama makine zekâsının tarama ve deneme kapasitesi, bu marjinalliği telafi edecek kadar büyük.
Bunun pratik anlamı şu: İnsanın araştırmadaki rolü üretmekten seçmeye ve doğrulamaya kayıyor. Hangi soru sorulmaya değer? Hangi sonuç güvenilir? Hangi bulgu gerçek dünyaya taşınmalı? Bu kararlar, ilerlemenin hızını belirleyen en önemli insani unsur hâline geliyor. Tarihteki büyük keşiflerin çoğu da aslında doğru soruyu sormakla başladı (Aziz Sancar ve DNA onarımı, 2026 Nobel Tıp Ödülü).
Şekil 3 · Araştırmada iş bölümü
Üretmekten seçmeye ve doğrulamaya
Tıp ve onkoloji için ne anlama geliyor?
Bu tablo tıpta da kendini göstermeye başladı. Yapay zekâ bir kan örneğinden birden çok hastalığı tanımaya, görüntülerde gözden kaçan bulguları yakalamaya ve büyük genomik verilerden tedavi hedefleri çıkarmaya başlıyor (tek kan örneğinden çok hastalık, kolonoskopide yapay zekâ, proteo-genomik harita). İnsan Genom Projesi'nin 13 yıl süren işini bugün günler içinde yapmak mümkün; tek bir kan örneğinden binlerce genin etkinliğini okuyup tedavi kararına çevirmek ise artık büyük ölçüde hesaplama gücüne dayanıyor (İnsan Genom Projesi, tam kan transkriptom atlası, aksiyon alınabilir transkriptom). Yapay zekâ, rutin görüntülerden yeni biyolojik bilgi çıkarmayı da mümkün kılıyor (PET-BT'de kahverengi yağ). Hipotez üretme ve veri analizi hızlandıkça, bir onkoloğun ya da araştırmacının asıl katkısı doğru soruyu sormak ve ortaya çıkan bulguyu eleştirel olarak sınamak olacak.
Ancak tıpta, yapay zekâ araştırmasında olmayan bir darboğaz daha var: klinik doğrulama. Bir ilacın gerçekten hastaların daha uzun ve daha iyi yaşamasını sağladığını göstermek için gönüllü hastalar, ilk insan çalışmalarından başlayan aşamalı bir süreç, yıllar süren izlem ve titiz güvenlik değerlendirmesi gerekir (faz 1 çalışma nedir?). Yapay zekâ bir hipotezi bir günde üretebilir, ama genel sağkalımı bir günde ölçemez. Akla yatkın görünen pek çok hipotezin büyük klinik çalışmalarda doğrulanamadığını hatırlamak gerekir (olumsuz sonuçlanan bir sonuç çalışması, klinik çalışma nedir?). Bu nedenle tıpta hızlanma, laboratuvardan çok klinik çalışma tasarımında, hasta seçiminde ve verinin doğru yorumlanmasında belirleyici olacak.
Hasta ile hekim arasındaki ilişki de değişiyor. Hastalarım artık muayeneye yapay zekâ ile hazırladıkları sorularla geliyor; bu bir tehdit değil, iyi yönetilirse bir fırsat (hasta yapay zekâ ile gelirse). Yapay zekânın reçete yazmaya kadar uzanan denemeleri ise sorumluluk ve güvenlik sorularını öne çıkarıyor (Utah'taki yapay zekâ reçete pilotu).
Temkinli olmak için nedenler
- Test puanları gerçek dünya değildir. Testlerde iyi olan bir model, karmaşık ve belirsiz gerçek dünya görevlerinde aynı başarıyı göstermeyebilir.
- Kendi bildirilen verimlilik yanıltıcı olabilir. METR'in 2025'teki randomize çalışmasında yazılımcılar kendilerini daha hızlı sanırken aslında daha yavaştı.
- Kanıtların bir kısmı gizli. Bağımsız bir değerlendirme olsa da en bilgilendirici veriler kamuya açık değil.
- Dış etkenler. Düzenlemeler, çip tedariki, enerji ve yeni bir yaklaşım ihtiyacı takvimi uzatabilir.
- Hızlı gelişen alanlarda abartı riski yüksektir. Bilimde abartının ve tanıtımın kanıtın önüne geçtiği örnekler az değil (bilimde abartı ve gerçek).
Kendimize sormamız gereken sorular
- Kurumum ya da ekibim, önümüzdeki 2-4 yıl için yapay zekânın araştırma ve klinik iş yükünü nasıl değiştireceğini planladı mı?
- Yapay zekâ ile üretilen bir sonucu hangi yöntemle doğruluyorum?
- Öğrencilerime ve asistanlarıma bilgi mi aktarıyorum, yoksa doğru soru sormayı ve eleştirel düşünmeyi mi öğretiyorum?
- Hasta verisini ve hasta güvenliğini koruyacak kurallar hazır mı?
- Bir bulguyu kliniğe taşıma kararını kim, hangi kanıtla veriyor?
- "Yapay zekâ artık kendi kendini geliştiriyor." Tam olarak değil. METR'e göre katkısı büyük ölçüde yardımcı nitelikte; en kritik işlerde tam bağımsız değil.
- "2029'da dönüştürücü yapay zekâ kesin geliyor." Hayır. Bu, tek bir yazarın olasılığa dayalı ortanca tahmini; daha erken de daha geç de olabilir.
- "Ölçülen hızlanma tüm yapay zekâ sektörü için geçerli." Değerlendirme tek bir şirkette yapıldı; diğer şirketlerin modellerinde hızlanma daha az görünüyor.
- "Yapay zekâ hekime ve araştırmacıya gerek bırakmayacak." Rolü değişecek: Üretmekten çok seçmek, doğrulamak ve sorumluluk almak öne çıkacak.
- "Yapay zekâ tıpta da her şeyi aynı hızda hızlandıracak." Klinik doğrulama hasta, zaman ve güvenlik gerektirir; bu darboğaz kendiliğinden ortadan kalkmaz.
Sıkça Sorulan Sorular
- METR raporu ne söylüyor?
- METR'in Kasım 2026'da yayımladığı bağımsız değerlendirmeye göre Anthropic modellerinin yetenek artış hızı Ekim 2025'ten sonra yaklaşık 1,9 katına çıktı (%95 GA 1,5-2,8). METR bu hızlanmanın büyük kısmını yapay zekânın araştırmaya katkısına bağlıyor, ancak yapay zekânın henüz araştırmayı tam bağımsız yürütmediğini belirtiyor.
- Dönüştürücü yapay zekâ ne zaman bekleniyor?
- Jonathan Mann'ın METR raporuna dayanan yorumunda ortanca tahmin 2029 ortası; bu, bir yıl önceki tahmininden yaklaşık bir yıl erken. Ani bir atılım olasılığı hesaba katıldığında 2028 ortası öne çıkıyor. Bu tahminler kesinlik değil, olasılıktır ve düzenlemeler ya da çip tedariki gibi etkenlerle değişebilir.
- Yapay zekâ bilimsel araştırmayı nasıl değiştiriyor?
- Yapay zekâ literatür tarama, hipotez üretme, veri analizi ve deney yürütme gibi işleri hızla üstleniyor. Bu nedenle insanın rolü üretmekten seçmeye ve doğrulamaya kayıyor: doğru soruyu seçmek, sonucu eleştirel olarak sınamak ve bulguyu sorumlulukla gerçek dünyaya taşımak öne çıkıyor.
- Bu hızlanma tıbbı nasıl etkileyecek?
- Tanı, görüntüleme, genomik analiz ve ilaç keşfinde hızlanma bekleniyor. Ancak bir tedavinin hastaya gerçek yarar sağladığını göstermek için klinik çalışmalar, yıllar süren izlem ve güvenlik değerlendirmesi gerekir. Bu darboğaz, yapay zekâ ne kadar hızlanırsa hızlansın önemini koruyacak.
Sözlük
- METR
- Yapay zekâ modellerinin yeteneklerini ve risklerini bağımsız olarak değerlendiren araştırma kuruluşu.
- AECI
- Anthropic'in iç ve dış testlerini birleştiren yetenek endeksi; Epoch Yetenek Endeksi'nin bir uyarlaması.
- Ar-Ge otomasyonu
- Araştırma ve geliştirme işlerinin bir kısmının yapay zekâ tarafından yapılması.
- Zaman ufku
- Bir yapay zekâ modelinin bağımsız olarak, belirli bir başarı oranıyla tamamlayabildiği görevlerin insan için gereken süresi.
- Katlanma süresi
- Bir ölçünün ikiye katlanması için geçen süre.
- TEDAI
- Dönüştürücü düzeyde yapay zekâ; ekonomiyi ve bilimi köklü biçimde değiştirebilecek yetenek düzeyi.
- Darboğaz
- Bir sürecin hızını sınırlayan en kıt kaynak.
- Azalan getiri
- Aynı çaba karşılığında elde edilen kazancın giderek küçülmesi.
- Güven aralığı
- Gerçek değerin belirli bir olasılıkla içinde bulunduğu tahmin aralığı.
- Klinik doğrulama
- Bir tanı ya da tedavinin hastada gerçek yarar sağladığının klinik çalışmalarla gösterilmesi.
DROZDOGAN Akademi Yorumu
Bu rapor bir tarih vermekten çok bir yön gösteriyor. Yapay zekânın gelişimi, kısmen kendi katkısıyla hızlanıyor ve bu hızlanma yakın vadede kendiliğinden yavaşlayacak gibi görünmüyor. Asıl soru "ne zaman" değil, "dikkatimizi neye ayıracağız" olmalı.
⚡ Neden önemli
Bilgiye erişimin neredeyse sınırsız ve ucuz hâle geldiği bir dünyada, rekabet avantajı bilgiye sahip olmakta değil, doğru soruyu seçmekte, sonucu eleştirel olarak sınamakta ve sorumlulukla uygulamakta olacak.
✅ Güçlü yönler
Şirket içi verilere erişen bağımsız bir değerlendirme; birden çok kanıt kaynağı; belirsizliklerin ve sınırların açıkça yazılması; güven aralığıyla verilen sayısal tahmin.
⚠️ Sınırlar
Kanıtların önemli kısmı karartılmış; tek bir şirket; test puanlarının gerçek dünyaya yansıması belirsiz; zaman tahminleri tek bir yazarın yorumu.
🩺 Pratikte
Ekibimde ve öğrencilerimde bilgiyi ezberlemekten çok doğru soruyu sormayı, kaynağı sorgulamayı ve sonucu sınamayı öne çıkarmaya çalışıyorum. Yapay zekânın ürettiği her bulguyu, hastaya yansımadan önce kanıta dayalı tıbbın süzgecinden geçirmeyi şart görüyorum.
❓ Açık sorular
Hızlanma diğer şirketlerde ve bilimin diğer alanlarında da görülecek mi? Test puanlarındaki artış gerçek dünyaya ne ölçüde yansıyacak? Klinik doğrulama süreçleri bu hıza nasıl uyum sağlayacak? Bu gücün güvenli ve adil kullanımını kim, nasıl denetleyecek?
Sonuç: En zeki insandan daha yetenekli sistemlerin olduğu bir dünyada avantaj, bilgiye erişimde değil, doğru soruyu seçmekte, sonucu eleştirel olarak sınamakta ve sorumlulukla uygulamakta olacak. Bu yetkinlikleri bugün kurumsal ve bireysel düzeyde inşa etmeyenler, ilerlemenin hızını değil yalnızca sonuçlarını izleyecek.
- Bu yazı Kasım 2026'da hazırlanmıştır.
- Rapora ilişkin bilgiler METR'in 5 Kasım 2026 tarihli yayımına dayanır. Raporun bazı bölümleri şirketin talebiyle karartılmıştır; METR bunu raporda açıkça belirtmektedir.
- Zaman tahminleri Jonathan Mann'ın kişisel blog yazısına dayanır; bir kurumun resmî tahmini değildir. "2 ila 4 yıllık pencere" bu yazarın varsayımlarıyla yapılmış kaba bir hesaptır.
- Yazıdaki grafik ve şemalar basitleştirilmiştir. Akademi yorumu bana aittir.
Kaynaklar
- METR. Independent assessment of AI R&D acceleration at Anthropic in October 2026 (5 November 2026). metr.org
- METR. Benchmarks provide one piece of evidence for acceleration (X, November 2026). x.com
- Mann J. My read on METR's AI R&D report. Abstraction (November 2026). abstraction.substack.com
- LessWrong. METR: Independent assessment of AI R&D acceleration at Anthropic (discussion). lesswrong.com
Bu yazı size yardımcı oldu mu?
Geri bildiriminiz içeriklerimizi geliştirmemize yardımcı olur.