Apple ve OpenEvidence’tan 200 Bin Kişilik Sağlık Yapay Zekâsı Çalışması: Sağlığınızla İlgili Neleri Soruyorsunuz?
Bu Makalede
Hastalar Sağlık Sorularını Yapay Zekâya Soruyor: Bu Kez 200.000 Kişide Bilimsel Olarak İncelenecek
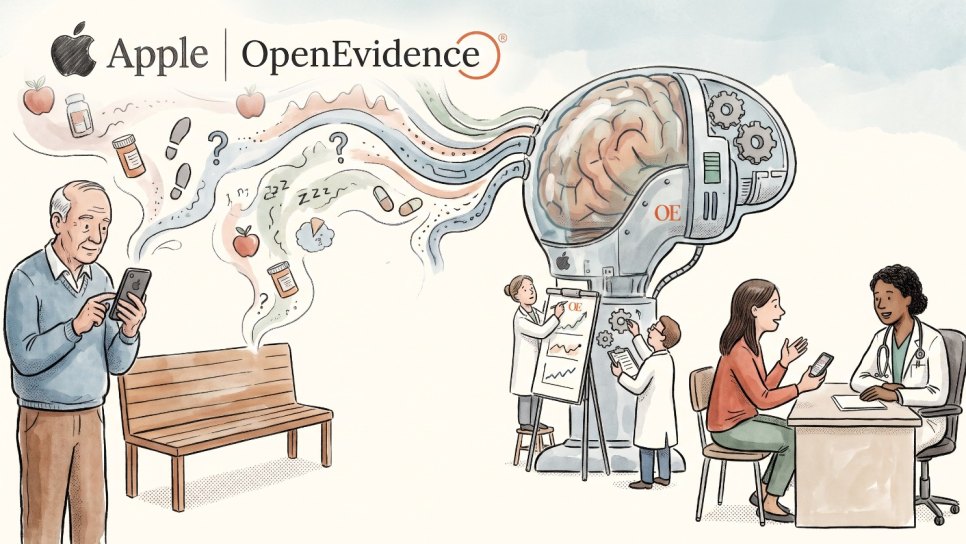
Apple, 15 Kasım 2026'da klinik yapay zekâ şirketi OpenEvidence ile birlikte, insanların sağlık sorularında yapay zekâyı nasıl kullandığını inceleyen büyük bir araştırma başlattı. ABD'de 21 yaş ve üzeri, uygun iPhone kullanan 200.000'e kadar yetişkinin katılabileceği çalışma, yapay zekâ yanıtlarının ne kadar anlaşıldığını, kullanıcıların bu yanıtlara ne kadar güvendiğini ve sağlık davranışlarını nasıl etkilediğini 12 aydan uzun süre izleyecek. Bu bir sonuç duyurusu değil, bir çalışmanın başlangıcı: Klinik yarar ya da güvenlik henüz gösterilmiş değil. Yine de muayenehaneme her gün yapay zekâ ile hazırlanmış sorularla gelen hastalarım düşünüldüğünde, bu soruların bilimsel olarak incelenmeye başlanmasını önemli buluyorum. Bu yazıda çalışmanın neyi ölçeceğini, neyi ölçemeyeceğini ve bugünden sağlık için yapay zekâ kullanırken nelere dikkat etmek gerektiğini anlatıyorum. Konuyu hekim açısından hasta yapay zekâ ile gelirse hekim nasıl yanıt vermeli? yazımda ele almıştım.
- Ne başladı? Apple Health AI Study: Katılımcılar uygulamaya günlük sağlık sorularını soruyor, hakemli kaynaklara dayanan sade yanıtlar alıyor, yanıtları puanlıyor ve aylık anketleri dolduruyor. İsteyen Sağlık uygulamasındaki nabız, uyku, hareket ve tahlil verilerini paylaşabiliyor.
- Neyi inceleyecek? Yapay zekâya duyulan güveni neyin belirlediğini, yanıtların ne kadar anlaşıldığını, gündelik sağlık davranışlarını ve kişisel sağlık verisinin yanıtı ne kadar anlamlı kıldığını. Hekim görüşmesine hazırlık da incelenecek.
- Sınırlar: Sonuç değil başlangıç. Tanı doğruluğu, hastalık sonuçları ya da zararlar doğrudan ölçülmüyor. Katılım yalnızca ABD'deki uygun iPhone kullanıcılarıyla sınırlı; bu da sonuçların genellenebilirliğini kısıtlıyor.
- Neden gerekli? 2026'da yayımlanan bir Oxford çalışmasında modeller tek başına vakaların %95'inde doğru hastalığı tanırken, aynı modelleri kullanan kişiler en fazla %34,5'inde tanıdı. Sorun bilgide değil, insan-makine etkileşiminde.
Bu konu neden önemli?
İnsanlar sağlık sorularını artık arama motorundan çok yapay zekâ sohbet araçlarına soruyor. OpenAI, 2026 başında ChatGPT'ye her hafta 300 milyondan fazla sağlıkla ilgili soru sorulduğunu açıkladı. Büyük yapay zekâ şirketleri sağlık odaklı ürünler çıkardı (AACR 2026 raporu ve yapay zekâ). Muayenehanemde de hastaların tahlil sonuçlarını, patoloji raporlarını ve tedavi seçeneklerini önceden yapay zekâ ile değerlendirdiğini sık görüyorum (tahlil değerlerini anlamak). Bu, iyi kullanıldığında hastanın sürece katılımını artırabilir; kötü kullanıldığında ise yanlış güven ya da gereksiz kaygı yaratabilir.
Ancak bugüne kadar yapay zekâ araçlarının değerlendirilmesi çoğunlukla sınav sorularında ya da hazır vakalarda modelin ne kadar doğru yanıt verdiğine dayanıyordu. Asıl önemli soru ise başka: Gerçek bir insan, kendi sağlık sorusunu sorduğunda yanıtı anlıyor mu, ona ne kadar güveniyor ve bu bilgiyle ne yapıyor? Hekimlerin kullandığı tanı araçlarında klinik doğrulama standartları oluşmaya başladı (kolonoskopide yapay zekâ, immünoterapi yanıtını öngören yapay zekâ, tek kan örneğinden çok hastalık); hastaların doğrudan kullandığı araçlarda ise bu yol daha yeni. Apple-OpenEvidence çalışması tam bu soruyu büyük ölçekte incelemeyi hedefliyor (tıbbi yayıncılıkta yapay zekâ kuralları).
Apple Health AI Study nedir?
Apple Health AI Study, Apple ve OpenEvidence'ın ABD'de 200.000'e kadar yetişkinle yürüttüğü sanal bir araştırmadır. Katılımcılar uygulamaya sağlık sorularını sorar, hakemli kaynaklara dayanan sade yanıtlar alır ve anketleri doldurur. Amaç, yapay zekâ yanıtlarının anlaşılmasını, güveni ve sağlık davranışlarını incelemektir.
OpenEvidence, ABD'de hekimler arasında yaygın kullanılan, yanıtlarını New England Journal of Medicine, JAMA ve Nature gibi tıbbi kaynaklara dayandıran bir klinik yapay zekâ platformu. Bu çalışmada aynı tıbbi temelin, uzman olmayan kişilere sade bir dille ve her yanıtta kaynak bağlantısıyla sunulması deneniyor. Katılım için ABD'de yaşamak, 21 yaş ve üzerinde olmak ve Apple Intelligence destekli bir iPhone (iPhone 15 Pro ve sonrası) ile iOS 26 kullanmak gerekiyor.
Şekil 1 · Katılımcının yolculuğu
Sorudan veriye
Çalışma neyi inceleyecek?
- Güven: Kullanıcıların yapay zekâ yanıtına güvenmesini ya da güvenmemesini ne belirliyor? Kaynak gösterilmesi, dilin sadeliği ya da kişisel verinin kullanılması güveni nasıl etkiliyor?
- Anlama: Karmaşık tıbbi bilgi sade dille anlatıldığında gerçekten anlaşılıyor mu?
- Yanıtın kalitesi: Kullanıcılar yanıtları nasıl puanlıyor?
- Davranış: Yanıtlar gündelik sağlık davranışlarını, örneğin hareket, uyku ya da hekime başvurma kararını nasıl etkiliyor?
- Kişisel veri: Nabız, uyku, hareket ve tahlil verilerinin paylaşılması yanıtı daha anlamlı ve anlaşılır kılıyor mu (dinlenme nabzı, fiziksel aktivite)?
- Hekim görüşmesine hazırlık: Uygulama, kişinin muayeneye daha hazırlıklı gitmesine yardımcı oluyor mu?
Son madde bence özellikle önemli. Hastalarımın bir kısmı, cinsellik ya da kaygı gibi konuları muayenede sormaktan çekiniyor (sormaktan çekinilen konular). İyi tasarlanmış bir araç, bu soruların muayeneye taşınmasına yardımcı olabilir. Ancak bunun gerçekten olup olmadığını bu tür çalışmalarla anlaşılacak.
Neden böyle bir çalışmaya ihtiyaç var?
Yapay zekâ modellerinin tıbbi bilgisi, sınav sorularında ve hazır vakalarda çok yüksek görünüyor. Ancak 2026'da Nature Medicine'da yayımlanan Oxford çalışması, bu başarının gerçek kullanıma yansımadığını gösterdi. İngiltere'den 1.298 kişiye on tıbbi senaryo verildi; kişiler rastgele üç farklı yapay zekâ modelinden birini ya da internet araması gibi alışıldık kaynakları kullandı. Modeller tek başına vakaların %94,9'unda doğru hastalığı tanırken, aynı modelleri kullanan kişiler en fazla %34,5'inde doğru hastalığa ulaştı ve kontrol grubundan daha başarılı olmadı. Kişiler modele çoğu zaman eksik bilgi verdi; modeller de zaman zaman yanıltıcı yanıtlar üretti. Araştırmacılar, mevcut modellerin doğrudan hasta bakımında kullanıma hazır olmadığı sonucuna vardı.
Model tek başına başarılı, insanla birlikte değil
Oxford çalışması, 1.298 kişi, 10 tıbbi senaryo (Nature Medicine, 2026); doğru yanıt oranı, %.
Modeli kullanan katılımcılar, internet araması gibi alışıldık kaynakları kullanan kontrol grubundan daha başarılı değildi. Kişiler modele çoğu zaman eksik bilgi verdi; modeller de zaman zaman yanıltıcı yanıtlar üretti. Model başarısı ile insanla birlikte gerçek kullanımdaki başarı aynı şey değil.
Bu bulgu, Apple-OpenEvidence çalışmasının neden önemli olduğunu açıklıyor: Sorun çoğu zaman bilgide değil, insan ile makinenin etkileşiminde. Doğru soruyu sormak, gerekli bilgiyi vermek ve yanıtı doğru yorumlamak, sanıldığından zor. Sağlık bilgisinin yanlış yorumlanmasının kanser hastalarında kanıtsız takviyelere ya da alternatif uygulamalara yönelmeye kadar uzanabildiğini sık görüyorum (kanıtsız takviyeler, tıbbi onkolog gözüyle alternatif tıp).
Çalışmanın sınırları
- Başlangıç, sonuç değil. Henüz hiçbir veri yok. Klinik yarar ya da güvenlik gösterilmiş değil.
- Klinik sonuç ölçülmüyor. Açıklanan hedefler güven, anlama ve kendi bildirilen davranışlar. Tanı doğruluğu, hastalık seyri, gereksiz başvurular ya da zararlar doğrudan ölçülmüyor gibi görünüyor.
- Seçilmiş katılımcılar. ABD'de yaşayan, 21 yaş ve üzeri, yeni ve pahalı bir iPhone kullanan, teknolojiye yatkın gönüllüler. Yaşlılar, düşük gelirli ya da sağlık okuryazarlığı düşük kişiler, yani yapay zekâ yanıtlarını yanlış anlama riski en yüksek gruplar yeterince temsil edilmeyebilir.
- Karşılaştırma grubu belirsiz. Açıklamalarda yapay zekâ kullanmayan bir kontrol grubundan söz edilmiyor; bu, nedensellik kurmayı zorlaştırır (klinik çalışma nedir?).
- Şirket tarafından yürütülüyor. Sağlık teknolojisinde iddiaların kanıtın önüne geçtiği örnekler az değil (bilimde abartı ve gerçek). Bağımsız akademik ortaklar, etik kurul süreci ve yayın planı açıklamada yer almıyor. Sonuçların hakemli dergilerde, olumsuz bulgular dahil, şeffaf biçimde yayımlanması gerekiyor (kanıta dayalı tıp, araştırma sonuçlarını doğru okumak).
Şekil 2 · Bu çalışmadan ne öğrenebiliriz?
Ölçebilecekleri ve ölçemeyecekleri
Gizlilik
Sağlık verisi en hassas kişisel veridir. Apple, çalışma verilerinin yapay zekâ modellerini eğitmek için kullanılmayacağını, verinin anonimleştirildikten sonra güvenli bir bulut sağlayıcısına aktarıldığını ve Sağlık uygulaması verilerini paylaşmanın tamamen isteğe bağlı olduğunu açıkladı. OpenEvidence de soru ve yanıt verilerini 24 saat sonra sildiğini belirtiyor. Bu güvenceler önemli, ancak her kullanıcının herhangi bir sağlık uygulamasına veri vermeden önce gizlilik koşullarını okuması gerekiyor.
Sağlık için yapay zekâ kullanırken nelere dikkat etmeli?
Bu çalışmanın sonuçlarını beklerken, sağlık sorularında yapay zekâ kullanan hastalarıma önerdiğim beş temel kural şunlar:
Şekil 3 · Sağlık sorusu sorarken beş kural
Yapay zekâ yardımcıdır, hekim değildir
Kanser tedavisi gören hastalarda bu kurallar daha da önemli. Ateş, nefes darlığı ya da yeni başlayan ağır bir yan etki gibi durumlar, yapay zekâ ile değerlendirilmeyi beklemeden onkoloji ekibine bildirilmelidir (tedavi sürecinde acil durumlar). Yapay zekânın önerdiği bitkisel ürün ya da takviyeler de tedaviyle etkileşebilir (takviyeler tedaviyi etkiler mi?, besin ve ilaç etkileşimleri).
Türkiye'de durum
Çalışma yalnızca ABD'deki katılımcılara açık; Türkiye'den katılım mümkün değil. Ülkemizde hastalar sağlık sorularını genel amaçlı yapay zekâ sohbet araçlarına soruyor ve bu araçların Türkçe tıbbi yanıtlarının doğruluğu ayrıca incelenmeyi bekliyor. Bu nedenle çalışmanın sonuçları, ülkemizdeki kullanıcılar için de dolaylı bir yol gösterici olacak. Yapay zekânın sağlıkta reçete yazmaya kadar uzanan kullanımlarının yarattığı sorumluluk sorularını Utah'taki yapay zekâ reçete pilotu yazımda ele almıştım.
Hekiminize sorabileceğiniz sorular
- Yapay zekâdan aldığım bu bilgi benim durumum için geçerli mi?
- Bu yanıtın dayandığı kaynak güvenilir mi, güncel mi?
- Tahlil ya da görüntüleme sonucumu yapay zekâ ile değerlendirdim; sizin yorumunuz ne?
- Hangi belirtilerde sizi ya da acil servisi hemen aramalıyım?
- Sağlık verilerimi bir uygulamayla paylaşmam güvenli mi?
- "Apple yapay zekânın sağlık için güvenli olduğunu gösterdi." Hayır. Çalışma yeni başladı; henüz hiçbir sonuç yok.
- "Model sınavlarda başarılıysa bana da doğru yanıt verir." Her zaman değil. Oxford çalışmasında modelin tek başına başarısı, kullanıcılara yansımadı.
- "Kaynak gösteriyorsa yanıt doğrudur." Kaynak önemli bir güvence ama yeterli değil; kaynağın sizin durumunuza uyup uymadığı ayrıca değerlendirilmelidir.
- "Yapay zekâ hekim muayenesinin yerini alabilir." Hayır. Muayene, kişisel öykü ve klinik yargı yerine konamaz; yapay zekâ en iyi ihtimalle muayeneye hazırlıkta yardımcıdır.
- "Bu çalışmaya Türkiye'den katılabilirim." Hayır. Katılım yalnızca ABD'deki uygun iPhone kullanıcılarına açık.
Sıkça Sorulan Sorular
- Apple ve OpenEvidence'ın sağlık yapay zekâsı çalışması nedir?
- Apple ve OpenEvidence'ın 15 Kasım 2026'da başlattığı, ABD'de 200.000'e kadar yetişkinin katılabileceği sanal bir araştırmadır. Katılımcılar uygulamaya sağlık sorularını sorar ve kaynaklı yanıtlar alır. Çalışma, yanıtların anlaşılmasını, kullanıcı güvenini ve sağlık davranışlarını 12 aydan uzun süre inceleyecek.
- Bu çalışmaya kimler katılabilir?
- ABD'de yaşayan, 21 yaş ve üzeri, Apple Intelligence destekli bir iPhone (iPhone 15 Pro ve sonrası) ve iOS 26 kullanan yetişkinler katılabilir. Türkiye'den katılım mümkün değildir.
- Yapay zekâ sağlık soruları için güvenilir mi?
- Henüz kesin bir yanıt yok. Modeller tıbbi sınavlarda çok başarılı, ancak 2026'daki bir Oxford çalışmasında modeli kullanan kişiler doğru hastalığa en fazla %34,5 oranında ulaştı ve internet aramasından daha başarılı olmadı. Yapay zekâ yanıtları hekimle paylaşılmalı, acil durumlarda kullanılmamalıdır.
- Sağlık için yapay zekâ kullanırken nelere dikkat etmeliyim?
- Yanıtın kaynağına bakın, yanıtı hekiminizle paylaşın, acil belirtilerde hemen acil servise başvurun, ilacınızı kendi başınıza değiştirmeyin ve sağlık verilerinizi paylaşmadan önce gizlilik koşullarını okuyun.
Sözlük
- OpenEvidence
- Yanıtlarını tıbbi dergilere ve kılavuzlara dayandıran, ABD'de hekimler arasında yaygın bir klinik yapay zekâ platformu.
- Büyük dil modeli
- Çok büyük metin verisiyle eğitilmiş, soru yanıtlayabilen ve metin üretebilen yapay zekâ modeli.
- Sanal klinik çalışma
- Katılımcıların merkeze gelmeden, telefon ya da internet üzerinden katıldığı araştırma.
- Onam
- Katılımcının çalışmayı anlayarak gönüllü olarak kabul etmesi.
- Sağlık okuryazarlığı
- Sağlık bilgisine ulaşma, onu anlama ve doğru kararlar için kullanabilme becerisi.
- HealthKit
- iPhone'daki Sağlık uygulamasının nabız, uyku, hareket ve tahlil gibi verileri bir araya getiren altyapısı.
- Kendi bildirilen sonuç
- Katılımcının anketle kendisinin bildirdiği bilgi; nesnel ölçümden farklıdır.
- Genellenebilirlik
- Bir çalışmanın sonuçlarının, çalışmaya katılmayan başka gruplara ne ölçüde uygulanabileceği.
- Kontrol grubu
- Karşılaştırma için incelenen yöntemi kullanmayan katılımcı grubu.
- Anonimleştirme
- Verinin kişiyi tanımlayan bilgilerden arındırılması.
DROZDOGAN Akademi Yorumu
Hastalar yapay zekâyı zaten kullanıyor; asıl soru bunu ne kadar iyi ve güvenli kullandıkları. Bu çalışma, sağlık yapay zekâsını "model ne kadar biliyor?" sorusundan "insan ne kadar anlıyor ve ne yapıyor?" sorusuna taşıdığı için önemli.
⚡ Neden önemli
Sağlık yapay zekâsının gerçek kullanıcılarla, büyük ölçekte ve uzun süre incelendiği ilk çalışmalardan biri. Sonuçları, hem bu araçların tasarımını hem de hekim-hasta iletişimini etkileyebilir.
✅ Güçlü yönler
Büyük örneklem; gerçek yaşamda kullanım; kaynak gösteren yanıtlar; isteğe bağlı kişisel veri; açıklanmış gizlilik güvenceleri; hekim görüşmesine hazırlığın da incelenmesi.
⚠️ Sınırlar
Henüz sonuç yok; klinik sonuçlar ve zararlar ölçülmüyor; seçilmiş ve teknolojiye yatkın katılımcılar; kontrol grubu belirsiz; şirket tarafından yürütülüyor.
🩺 Pratikte
Hastalarımın yapay zekâ ile hazırladığı soruları muayenede memnuniyetle konuşuyorum. Yanıtın kaynağını birlikte değerlendiriyor, kişisel durumlarına uyup uymadığını açıklıyorum. Acil belirtilerde ve tedavi değişikliklerinde yapay zekâya değil ekibimize başvurmalarını özellikle vurguluyorum.
❓ Açık sorular
Kaynaklı yanıtlar gerçekten daha iyi anlaşılıyor mu? Yapay zekâ kullanımı gereksiz hekim başvurularını azaltıyor mu, artırıyor mu? Yaşlılar ve sağlık okuryazarlığı düşük kişiler bu araçlardan aynı ölçüde yararlanabilecek mi? Sonuçlar bağımsız ve şeffaf biçimde yayımlanacak mı?
Sonuç: Apple-OpenEvidence çalışması, sağlık yapay zekâsının gerçek insanlar üzerindeki etkisini anlamak için doğru soruyu soruyor. Ancak bu bir başlangıç: Klinik yarar ve güvenlik gösterilene kadar yapay zekâ, hekimle birlikte kullanılan bir yardımcı olarak kalmalı.
- Bu yazı Kasım 2026'da hazırlanmıştır.
- Çalışmaya ilişkin bilgiler Apple'ın 15 Kasım 2026 tarihli duyurusuna ve haberlere dayanır. Çalışmanın etik kurul süreci, akademik ortakları, kontrol grubu ve yayın planı duyuruda yer almamaktadır.
- Uygun iPhone modelleri için Apple'ın kendi duyurusu esas alınmıştır; bazı haberlerde farklı model aralığı belirtilmiştir.
- Şemalar basitleştirilmiştir. Akademi yorumu bana aittir. Bu yazı tıbbi tavsiye değildir; sağlık kararlarınızı hekiminizle birlikte verin.
Kaynaklar
- Apple Newsroom. Apple launches research study to explore the use of AI for health (15 November 2026). apple.com
- TechCrunch. Apple launches new app to study how people use AI for health (15 November 2026). techcrunch.com
- Bean AM, Payne R, Mahdi A, et al. Reliability of LLMs as medical assistants for the general public: a randomized preregistered study. Nature Medicine 2026. scimex.org
- Perez MV, Mahaffey KW, Hedlin H, et al. Large-scale assessment of a smartwatch to identify atrial fibrillation (Apple Heart Study). N Engl J Med 2019;381:1909-1917. doi:10.1056/NEJMoa1901183. nejm.org
Bu yazı size yardımcı oldu mu?
Geri bildiriminiz içeriklerimizi geliştirmemize yardımcı olur.