بیماران پرسشهای سلامت خود را از هوش مصنوعی میپرسند: این بار در 200,000 نفر بهصورت علمی بررسی میشود
در این مقاله
بیماران پرسشهای سلامت خود را از هوش مصنوعی میپرسند: این بار در 200,000 نفر بهصورت علمی بررسی میشود
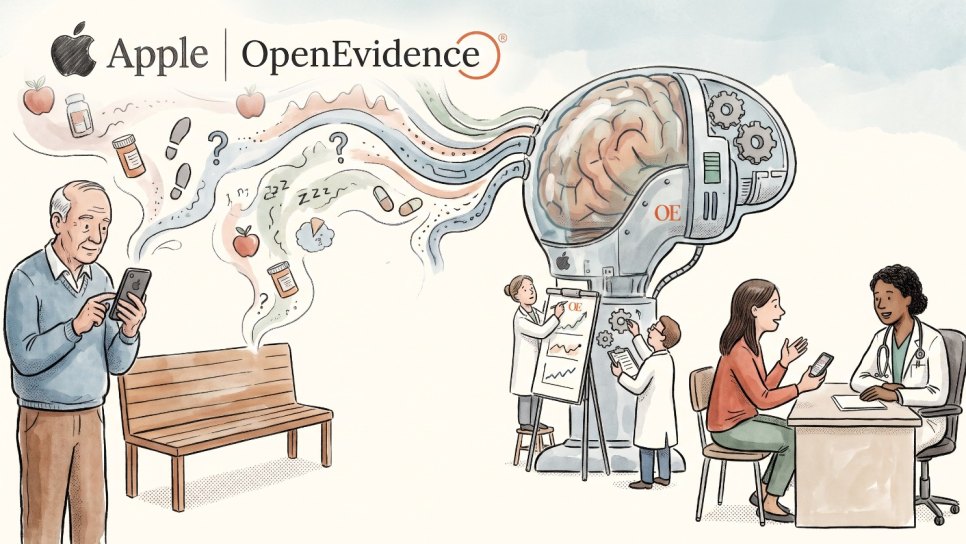
اپل در 15 نوامبر 2026 همراه با شرکت هوش مصنوعی بالینی OpenEvidence پژوهشی بزرگ را آغاز کرد که بررسی میکند مردم در پرسشهای مربوط به سلامت چگونه از هوش مصنوعی استفاده میکنند. در این مطالعه تا 200,000 بزرگسال ساکن آمریکا، 21 ساله و بالاتر که از آیفون مناسب استفاده میکنند میتوانند شرکت کنند. پژوهش بیش از 12 ماه پیگیری خواهد کرد که پاسخهای هوش مصنوعی تا چه اندازه فهمیده میشوند، کاربران چقدر به آنها اعتماد میکنند و این پاسخها بر رفتارهای سلامت چه تأثیری دارند. این اعلام نتیجه نیست، آغاز یک مطالعه است: فایده یا ایمنی بالینی هنوز نشان داده نشده است. با این حال، وقتی به بیمارانم فکر میکنم که هر روز با پرسشهایی که با هوش مصنوعی آماده کردهاند به مطب میآیند، شروع بررسی علمی این پرسشها را مهم میدانم. در این مقاله توضیح میدهم که مطالعه چه چیزی را میسنجد، چه چیزی را نمیتواند بسنجد و امروز هنگام استفاده از هوش مصنوعی برای سلامت به چه نکاتی باید توجه کرد. این موضوع را از دیدگاه پزشک در مقاله اگر بیمار با هوش مصنوعی بیاید پزشک چگونه باید پاسخ دهد؟ (به ترکی) بررسی کرده بودم.
- چه چیزی آغاز شد؟ Apple Health AI Study: شرکتکنندگان پرسشهای روزمره سلامت را از برنامه میپرسند، پاسخهای ساده مبتنی بر منابع داوریشده دریافت میکنند، پاسخها را امتیاز میدهند و پرسشنامههای ماهانه را پر میکنند. هر کس بخواهد میتواند دادههای ضربان قلب، خواب، فعالیت و آزمایشهای برنامه Health را به اشتراک بگذارد.
- چه چیزی را بررسی میکند؟ اینکه چه چیزی اعتماد به هوش مصنوعی را تعیین میکند، پاسخها چقدر فهمیده میشوند، رفتارهای روزمره سلامت چگونه است و دادههای شخصی سلامت پاسخ را چقدر معنادار میکند. آمادگی برای ملاقات با پزشک نیز بررسی خواهد شد.
- محدودیتها: آغاز است، نه نتیجه. دقت تشخیص، پیامدهای بیماری یا آسیبها مستقیم سنجیده نمیشوند. شرکت فقط برای کاربران آیفون مناسب در آمریکا ممکن است؛ این موضوع تعمیمپذیری نتایج را محدود میکند.
- چرا لازم است؟ در یک مطالعه آکسفورد که در 2026 منتشر شد، مدلها بهتنهایی در 95 درصد موارد بیماری درست را تشخیص دادند، اما افرادی که از همان مدلها استفاده کردند حداکثر در 34٫5 درصد موارد موفق شدند. مشکل در دانش نیست، در تعامل انسان و ماشین است.
چرا این موضوع مهم است؟
مردم اکنون پرسشهای سلامت خود را بیشتر از موتور جستوجو از ابزارهای گفتوگوی هوش مصنوعی میپرسند. OpenAI در اوایل 2026 اعلام کرد که هر هفته بیش از 300 میلیون پرسش مرتبط با سلامت از ChatGPT پرسیده میشود. شرکتهای بزرگ هوش مصنوعی محصولاتی با تمرکز بر سلامت عرضه کردهاند (گزارش AACR 2026 و هوش مصنوعی، به ترکی). در مطب خود نیز اغلب میبینم که بیماران نتایج آزمایش، گزارشهای آسیبشناسی و گزینههای درمانی را از پیش با هوش مصنوعی ارزیابی کردهاند (فهمیدن مقادیر آزمایش، به ترکی). این کار اگر درست انجام شود میتواند مشارکت بیمار در روند درمان را افزایش دهد؛ اگر نادرست باشد، میتواند اعتماد نادرست یا نگرانی بیمورد ایجاد کند.
اما تا امروز ارزیابی ابزارهای هوش مصنوعی بیشتر بر این پایه بود که مدل در پرسشهای امتحانی یا موارد آماده چقدر درست پاسخ میدهد. پرسش اصلی چیز دیگری است: وقتی یک انسان واقعی پرسش سلامت خود را میپرسد، آیا پاسخ را میفهمد، چقدر به آن اعتماد میکند و با این اطلاعات چه میکند؟ در ابزارهای تشخیصی که پزشکان به کار میبرند، استانداردهای اعتبارسنجی بالینی شکل گرفته است (هوش مصنوعی در کولونوسکوپی، هوش مصنوعی پیشبینیکننده پاسخ به ایمونوتراپی، بیماریهای متعدد از یک نمونه خون؛ همه به ترکی)؛ اما برای ابزارهایی که بیماران مستقیم به کار میبرند این مسیر تازهتر است. مطالعه Apple-OpenEvidence هدف دارد دقیقاً همین پرسش را در مقیاس بزرگ بررسی کند (قواعد هوش مصنوعی در انتشارات پزشکی، به ترکی).
Apple Health AI Study چیست؟
Apple Health AI Study پژوهشی مجازی است که اپل و OpenEvidence با شرکت تا 200,000 بزرگسال در آمریکا اجرا میکنند. شرکتکنندگان پرسشهای سلامت را از برنامه میپرسند، پاسخهای ساده مبتنی بر منابع داوریشده دریافت میکنند و پرسشنامهها را پر میکنند. هدف، بررسی فهم پاسخهای هوش مصنوعی، اعتماد و رفتارهای سلامت است.
OpenEvidence یک پلتفرم هوش مصنوعی بالینی است که میان پزشکان آمریکایی رایج است و پاسخهایش را بر منابع پزشکی مانند New England Journal of Medicine، JAMA و Nature استوار میکند. در این مطالعه آزمایش میشود که همین پایه پزشکی با زبان ساده و با پیوند منبع در هر پاسخ به افراد غیرمتخصص ارائه شود. برای شرکت باید در آمریکا زندگی کرد، 21 سال یا بیشتر داشت و از آیفون سازگار با Apple Intelligence (iPhone 15 Pro و جدیدتر) با iOS 26 استفاده کرد.
شکل 1 · مسیر شرکتکننده
از پرسش تا داده
مطالعه چه چیزی را بررسی خواهد کرد؟
- اعتماد: چه چیزی تعیین میکند کاربران به پاسخ هوش مصنوعی اعتماد کنند یا نکنند؟ ذکر منبع، سادگی زبان یا استفاده از دادههای شخصی چگونه بر اعتماد اثر میگذارد؟
- فهم: آیا وقتی اطلاعات پیچیده پزشکی با زبان ساده توضیح داده میشود واقعاً فهمیده میشود؟
- کیفیت پاسخ: کاربران پاسخها را چگونه امتیاز میدهند؟
- رفتار: پاسخها بر رفتارهای روزمره سلامت، مثلاً تحرک، خواب یا تصمیم به مراجعه به پزشک، چه اثری دارند؟
- داده شخصی: آیا اشتراک دادههای ضربان، خواب، فعالیت و آزمایش پاسخ را معنادارتر و قابلفهمتر میکند (ضربان قلب در حال استراحت، فعالیت بدنی؛ هر دو به ترکی)؟
- آمادگی برای ملاقات با پزشک: آیا برنامه به فرد کمک میکند آمادهتر به ویزیت برود؟
به نظر من آخرین مورد اهمیت ویژهای دارد. بخشی از بیماران من از پرسیدن موضوعاتی مانند مسائل جنسی یا اضطراب در ویزیت خودداری میکنند (موضوعاتی که از پرسیدنشان پرهیز میشود، به ترکی). ابزاری که خوب طراحی شده باشد میتواند به آوردن این پرسشها به ویزیت کمک کند. اما اینکه واقعاً چنین میشود یا نه، با اینگونه مطالعهها روشن خواهد شد.
چرا به چنین مطالعهای نیاز است؟
دانش پزشکی مدلهای هوش مصنوعی در پرسشهای امتحانی و موارد آماده بسیار بالا به نظر میرسد. اما مطالعه آکسفورد که در 2026 در Nature Medicine منتشر شد نشان داد این موفقیت به استفاده واقعی منتقل نمیشود. به 1,298 نفر از بریتانیا ده سناریوی پزشکی داده شد؛ افراد بهطور تصادفی از یکی از سه مدل هوش مصنوعی یا از منابع معمول مانند جستوجوی اینترنتی استفاده کردند. مدلها بهتنهایی در 94٫9 درصد موارد بیماری درست را تشخیص دادند، اما افرادی که از همان مدلها استفاده کردند حداکثر در 34٫5 درصد موارد به بیماری درست رسیدند و از گروه کنترل موفقتر نبودند. افراد اغلب اطلاعات ناقصی به مدل دادند؛ مدلها نیز گاهی پاسخهای گمراهکننده تولید کردند. پژوهشگران نتیجه گرفتند مدلهای کنونی برای استفاده مستقیم در مراقبت از بیمار آماده نیستند.
مدل بهتنهایی موفق است، همراه با انسان نه
مطالعه آکسفورد، 1,298 نفر، 10 سناریوی پزشکی (Nature Medicine، 2026)؛ نسبت پاسخ درست، درصد.
شرکتکنندگانی که از مدل استفاده کردند از گروه کنترل که منابع معمول مانند جستوجوی اینترنتی را به کار میبردند موفقتر نبودند. افراد اغلب اطلاعات ناقصی به مدل دادند؛ مدلها نیز گاهی پاسخهای گمراهکننده تولید کردند. موفقیت مدل با موفقیت همراه با انسان در استفاده واقعی یکی نیست.
این یافته توضیح میدهد چرا مطالعه Apple-OpenEvidence مهم است: مشکل اغلب در دانش نیست، در تعامل انسان و ماشین است. پرسیدن پرسش درست، ارائه اطلاعات لازم و تفسیر درست پاسخ از آنچه تصور میشود دشوارتر است. اغلب میبینم که تفسیر نادرست اطلاعات سلامت در بیماران سرطانی تا گرایش به مکملهای بدون شواهد یا روشهای جایگزین پیش میرود (مکملهای بدون شواهد، طب جایگزین از دید یک انکولوژیست؛ هر دو به ترکی).
محدودیتهای مطالعه
- آغاز است، نه نتیجه. هنوز هیچ دادهای وجود ندارد. فایده یا ایمنی بالینی نشان داده نشده است.
- پیامد بالینی سنجیده نمیشود. اهداف اعلامشده اعتماد، فهم و رفتارهای خودگزارشی است. به نظر میرسد دقت تشخیص، سیر بیماری، مراجعههای غیرضروری یا آسیبها مستقیم سنجیده نمیشوند.
- شرکتکنندگان گزینششده. داوطلبانی که در آمریکا زندگی میکنند، 21 سال یا بالاتر دارند، آیفون جدید و گران دارند و به فناوری تمایل دارند. سالمندان، افراد کمدرآمد یا کمسواد سلامت، یعنی گروههایی که بیشترین خطر سوءبرداشت از پاسخهای هوش مصنوعی را دارند، ممکن است به اندازه کافی نمایندگی نشوند.
- گروه مقایسه نامشخص است. در توضیحات از گروه کنترل بدون هوش مصنوعی سخنی نیست؛ این موضوع برقراری رابطه علّی را دشوار میکند (مطالعه بالینی چیست؟، به ترکی).
- توسط شرکت اجرا میشود. در فناوری سلامت نمونههایی که ادعا از شواهد جلو افتاده کم نیست (اغراق و واقعیت در علم، به ترکی). شرکای دانشگاهی مستقل، روند کمیته اخلاق و برنامه انتشار در اعلامیه نیامده است. لازم است نتایج، از جمله یافتههای منفی، بهصورت شفاف در مجلههای داوریشده منتشر شود (پزشکی مبتنی بر شواهد، خواندن درست نتایج پژوهش؛ هر دو به ترکی).
شکل 2 · از این مطالعه چه میتوان آموخت؟
آنچه میتواند و نمیتواند بسنجد
حریم خصوصی
دادههای سلامت حساسترین دادههای شخصی هستند. اپل اعلام کرده است که دادههای مطالعه برای آموزش مدلهای هوش مصنوعی استفاده نخواهد شد، دادهها پس از ناشناسسازی به یک ارائهدهنده ابر امن منتقل میشوند و اشتراک دادههای برنامه سلامت کاملاً اختیاری است. OpenEvidence نیز میگوید دادههای پرسش و پاسخ را پس از 24 ساعت حذف میکند. این تضمینها مهماند، اما هر کاربر پیش از دادن داده به هر برنامه سلامت باید شرایط حریم خصوصی را بخواند.
هنگام استفاده از هوش مصنوعی برای سلامت به چه نکاتی باید توجه کرد؟
تا زمان آشکار شدن نتایج این مطالعه، پنج قاعده اصلی که به بیمارانم که برای پرسشهای سلامت از هوش مصنوعی استفاده میکنند توصیه میکنم اینهاست:
شکل 3 · پنج قاعده هنگام پرسیدن پرسش سلامت
هوش مصنوعی یاور است، پزشک نیست
در بیمارانی که درمان سرطان میگیرند این قواعد مهمتر نیز هست. وضعیتهایی مانند تب، تنگی نفس یا عارضه جانبی شدید تازه آغازشده باید بدون انتظار برای ارزیابی با هوش مصنوعی به تیم انکولوژی اطلاع داده شود (شرایط اورژانسی در روند درمان، به ترکی). محصولات گیاهی یا مکملهایی که هوش مصنوعی پیشنهاد میکند نیز ممکن است با درمان اثر متقابل داشته باشند (آیا مکملها بر درمان اثر میگذارند؟، اثر متقابل غذا و دارو؛ هر دو به ترکی).
وضعیت در ترکیه
مطالعه فقط برای شرکتکنندگان در آمریکا باز است؛ شرکت از ترکیه ممکن نیست. در کشور ما بیماران پرسشهای سلامت را از ابزارهای گفتوگوی عمومی هوش مصنوعی میپرسند و دقت پاسخهای پزشکی ترکی این ابزارها هنوز باید جداگانه بررسی شود. بنابراین نتایج این مطالعه برای کاربران کشور ما نیز راهنمایی غیرمستقیم خواهد بود. پرسشهای مسئولیت ناشی از کاربردهای هوش مصنوعی در سلامت، تا نسخهنویسی، را در مقاله پایلوت نسخهنویسی هوش مصنوعی در یوتا (به ترکی) بررسی کرده بودم.
پرسشهایی که میتوانید از پزشک خود بپرسید
- آیا این اطلاعاتی که از هوش مصنوعی گرفتم برای وضعیت من درست است؟
- آیا منبعی که این پاسخ بر آن استوار است معتبر و بهروز است؟
- نتیجه آزمایش یا تصویربرداری خود را با هوش مصنوعی ارزیابی کردم؛ نظر شما چیست؟
- در چه علائمی باید فوراً با شما یا اورژانس تماس بگیرم؟
- آیا به اشتراک گذاشتن دادههای سلامتم با یک برنامه ایمن است؟
- «اپل نشان داد هوش مصنوعی برای سلامت ایمن است.» خیر. مطالعه تازه آغاز شده است؛ هنوز هیچ نتیجهای وجود ندارد.
- «اگر مدل در امتحانها موفق است، به من هم پاسخ درست میدهد.» همیشه نه. در مطالعه آکسفورد موفقیت مدل بهتنهایی به کاربران منتقل نشد.
- «اگر منبع نشان دهد، پاسخ درست است.» منبع تضمین مهمی است اما کافی نیست؛ اینکه منبع با وضعیت شما سازگار است یا نه باید جداگانه ارزیابی شود.
- «هوش مصنوعی میتواند جای معاینه پزشک را بگیرد.» خیر. معاینه، شرح حال شخصی و قضاوت بالینی جایگزینپذیر نیستند؛ هوش مصنوعی در بهترین حالت در آمادگی برای ویزیت یاور است.
- «میتوانم از ترکیه در این مطالعه شرکت کنم.» خیر. شرکت فقط برای کاربران آیفون مناسب در آمریکا باز است.
پرسشهای متداول
- مطالعه هوش مصنوعی سلامت اپل و OpenEvidence چیست؟
- پژوهشی مجازی است که اپل و OpenEvidence در 15 نوامبر 2026 آغاز کردند و تا 200,000 بزرگسال در آمریکا میتوانند در آن شرکت کنند. شرکتکنندگان پرسشهای سلامت را از برنامه میپرسند و پاسخهای منبعدار دریافت میکنند. مطالعه فهم پاسخها، اعتماد کاربران و رفتارهای سلامت را بیش از 12 ماه بررسی خواهد کرد.
- چه کسانی میتوانند در این مطالعه شرکت کنند؟
- بزرگسالان ساکن آمریکا، 21 ساله و بالاتر، که از آیفون سازگار با Apple Intelligence (iPhone 15 Pro و جدیدتر) و iOS 26 استفاده میکنند. شرکت از ترکیه ممکن نیست.
- آیا هوش مصنوعی برای پرسشهای سلامت قابلاعتماد است؟
- هنوز پاسخ قطعی وجود ندارد. مدلها در امتحانهای پزشکی بسیار موفقاند، اما در یک مطالعه آکسفورد در 2026 افرادی که از مدل استفاده کردند حداکثر در 34٫5 درصد موارد به بیماری درست رسیدند و از جستوجوی اینترنتی موفقتر نبودند. پاسخهای هوش مصنوعی باید با پزشک در میان گذاشته شوند و در شرایط اورژانسی به کار نروند.
- هنگام استفاده از هوش مصنوعی برای سلامت به چه نکاتی باید توجه کنم؟
- به منبع پاسخ نگاه کنید، پاسخ را با پزشک خود در میان بگذارید، در علائم اورژانسی فوراً به اورژانس مراجعه کنید، داروی خود را خودسرانه تغییر ندهید و پیش از به اشتراک گذاشتن دادههای سلامت شرایط حریم خصوصی را بخوانید.
واژهنامه
- OpenEvidence
- پلتفرم هوش مصنوعی بالینی رایج میان پزشکان آمریکایی که پاسخهایش را بر مجلهها و رهنمودهای پزشکی استوار میکند.
- مدل زبانی بزرگ
- مدل هوش مصنوعی آموزشدیده با دادههای متنی بسیار بزرگ که میتواند به پرسشها پاسخ دهد و متن تولید کند.
- مطالعه بالینی مجازی
- پژوهشی که شرکتکنندگان بدون مراجعه به مرکز، از طریق تلفن یا اینترنت در آن شرکت میکنند.
- رضایت آگاهانه
- پذیرش داوطلبانه مطالعه توسط شرکتکننده، پس از فهم آن.
- سواد سلامت
- توانایی دسترسی به اطلاعات سلامت، فهم آن و به کار بردنش برای تصمیمهای درست.
- HealthKit
- زیرساخت برنامه Health در آیفون که دادههایی مانند ضربان، خواب، فعالیت و آزمایش را گرد هم میآورد.
- پیامد خودگزارشی
- اطلاعاتی که شرکتکننده خودش در پرسشنامه گزارش میکند؛ با اندازهگیری عینی تفاوت دارد.
- تعمیمپذیری
- اینکه نتایج یک مطالعه تا چه اندازه به گروههای دیگری که در مطالعه شرکت نداشتند قابل اعمال است.
- گروه کنترل
- گروه شرکتکنندگانی که برای مقایسه، روش مورد بررسی را به کار نمیبرند.
- ناشناسسازی
- پاکسازی داده از اطلاعاتی که هویت فرد را مشخص میکنند.
دیدگاه آکادمی DROZDOGAN
بیماران هماکنون از هوش مصنوعی استفاده میکنند؛ پرسش اصلی این است که چقدر خوب و ایمن از آن استفاده میکنند. این مطالعه از آن جهت مهم است که هوش مصنوعی سلامت را از پرسش «مدل چقدر میداند؟» به پرسش «انسان چقدر میفهمد و چه میکند؟» میبرد.
⚡ چرا مهم است
یکی از نخستین مطالعههایی که هوش مصنوعی سلامت را با کاربران واقعی، در مقیاس بزرگ و برای مدت طولانی بررسی میکند. نتایج آن میتواند هم بر طراحی این ابزارها و هم بر ارتباط پزشک و بیمار اثر بگذارد.
✅ نقاط قوت
نمونه بزرگ؛ استفاده در زندگی واقعی؛ پاسخهای منبعدار؛ داده شخصی اختیاری؛ تضمینهای اعلامشده حریم خصوصی؛ بررسی آمادگی برای ملاقات با پزشک.
⚠️ محدودیتها
هنوز نتیجهای نیست؛ پیامدهای بالینی و آسیبها سنجیده نمیشوند؛ شرکتکنندگان گزینششده و گرایشمند به فناوری؛ گروه کنترل نامشخص؛ اجرا توسط شرکت.
🩺 در عمل
پرسشهایی را که بیمارانم با هوش مصنوعی آماده کردهاند با رضایت در ویزیت بررسی میکنم. منبع پاسخ را با هم ارزیابی میکنم و توضیح میدهم که با وضعیت شخصیشان سازگار است یا نه. بهویژه تأکید میکنم که در علائم اورژانسی و تغییر درمان به هوش مصنوعی نه، به تیم ما مراجعه کنند.
❓ پرسشهای باز
آیا پاسخهای منبعدار واقعاً بهتر فهمیده میشوند؟ آیا استفاده از هوش مصنوعی مراجعههای غیرضروری به پزشک را کم میکند یا زیاد؟ آیا سالمندان و افراد کمسواد سلامت به همان اندازه از این ابزارها بهره خواهند برد؟ آیا نتایج بهصورت مستقل و شفاف منتشر خواهد شد؟
نتیجه: مطالعه Apple-OpenEvidence پرسش درست را برای فهم اثر هوش مصنوعی سلامت بر انسانهای واقعی مطرح میکند. اما این آغاز است: تا زمانی که فایده و ایمنی بالینی نشان داده نشود، هوش مصنوعی باید یاوری بماند که همراه با پزشک به کار میرود.
- این مقاله در نوامبر 2026 تهیه شده است.
- اطلاعات مربوط به مطالعه بر اعلامیه 15 نوامبر 2026 اپل و گزارشهای خبری استوار است. روند کمیته اخلاق، شرکای دانشگاهی، گروه کنترل و برنامه انتشار مطالعه در اعلامیه نیامده است.
- برای مدلهای آیفون مناسب، اعلامیه خود اپل مبنا قرار گرفته است؛ در برخی گزارشها دامنه مدل متفاوتی ذکر شده است.
- نمودارها سادهسازی شدهاند. دیدگاه آکادمی از آنِ من است. این مقاله توصیه پزشکی نیست؛ تصمیمهای سلامت خود را همراه با پزشکتان بگیرید.
منابع
- Apple Newsroom. Apple launches research study to explore the use of AI for health (15 November 2026). apple.com
- TechCrunch. Apple launches new app to study how people use AI for health (15 November 2026). techcrunch.com
- Bean AM, Payne R, Mahdi A, et al. Reliability of LLMs as medical assistants for the general public: a randomized preregistered study. Nature Medicine 2026. scimex.org
- Perez MV, Mahaffey KW, Hedlin H, et al. Large-scale assessment of a smartwatch to identify atrial fibrillation (Apple Heart Study). N Engl J Med 2019;381:1909-1917. doi:10.1056/NEJMoa1901183. nejm.org
آیا این مقاله برای شما مفید بود؟
بازخورد شما به بهبود محتوای ما کمک میکند.