Bilimsel Makaleyi Yapay Zekâ Ajanına Çevirmek – ve İstemeden Tekrarlanabilirliği Ölçmek
Paper2Agent: bilimsel makaleyi yapay zekâ ajanına çeviren sistem
Bir bilimsel makale, yayımlandığı andan itibaren pasif bir nesnedir. Okursunuz, anlamaya çalışırsınız, kendi işinize uyarlamak isterseniz yazarın kodunu bulup indirmeniz, ortamı kurmanız ve yöntemi çözmeniz gerekir. Stanford'dan bir ekip bunu değiştirmeyi öneriyor: makaleyi, kendisiyle konuşabildiğiniz ve yöntemini kendi verinizde çalıştırabildiğiniz bir yapay zekâ ajanına dönüştürmek. Sistemin adı Paper2Agent ve Nature'da yayımlandı. Ama asıl çarpıcı sonuç, sistemin ne yaptığında değil — ne yapamadığında.
Yazının omurgası budur: 100 hesaplamalı biyoloji makalesinden yalnız 74'ü ajana dönüştürülebildi. Geri kalan 26'sı, kodu eksik olduğu, verisi bulunamadığı ya da çalışma ortamı kurulamadığı için dönüştürülemedi. Yazarların kendi cümlesiyle: "Bir makalenin ne kolaylıkla ajana dönüştürülebildiği, başlı başına pratik bir tekrarlanabilirlik ölçütü olabilir."
Yani bu araç, aynı zamanda istemeden bir denetim aracı haline geliyor.
| Başlık | "Reimagining research papers as interactive and reliable AI agents" |
| Yazarlar | Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard, James Zou |
| Kurum | Stanford Üniversitesi |
| Dergi | Nature · DOI 10.1038/s41586-026-11044-y |
| Süreç | Gönderim 13 Ekim 2025 · Kabul 14 Ağustos 2026 |
| Erişim | Açık erişim |
| Canlı demo | paper2agent.ai/live |
| Kullanılan altyapı | Claude Code ve MCP (Model Context Protocol) sunucuları |
Çözmeye çalıştığı sorun
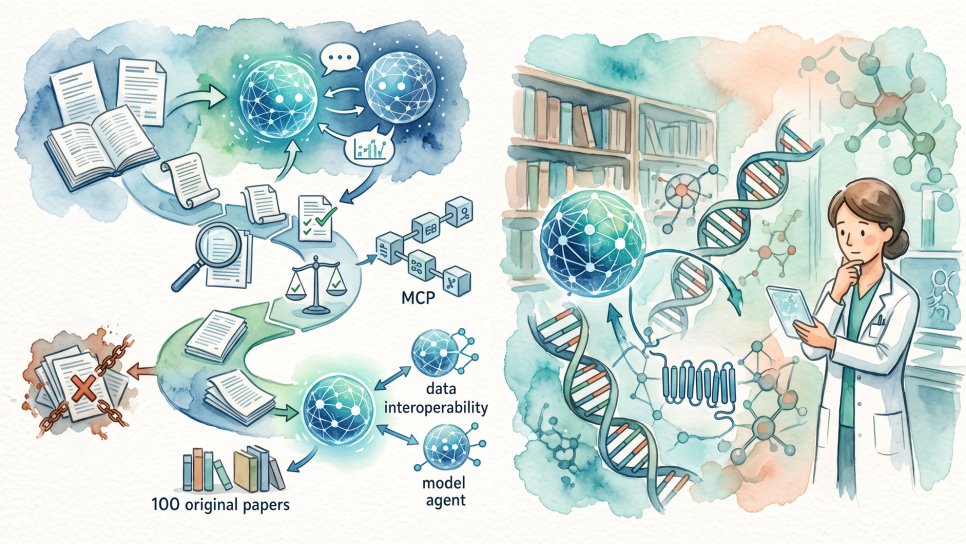
Yazarlar sorunu somut bir örnekle anlatıyor. AlphaGenome, genom ölçeğinde güçlü tahminler yapabilen bir model. Ama kullanabilmek için: depoyu bulmanız, ortamı kurmanız, API anahtarı almanız, istemci nesneleri oluşturmanız, varyant nesneleri inşa etmeniz ve hangi çıktı biçimini istediğinizi seçmeniz gerekir. Bu, moleküler biyolog için ciddi bir öğrenme eğrisidir.
Makalelerin temel çelişkisi şudur: Bir yöntem makalesinin değeri, o yöntemin kullanılmasındadır. Ama makale formatı, yöntemi kullanmayı değil anlatmayı optimize eder. Aradaki boşluğu okuyucu kendi emeğiyle doldurmak zorundadır — ve çoğu zaman dolduramaz. Yazarların ifadesiyle araştırma çıktıları "teknik engellerin arkasında pasif biçimde siloya kapatılmıştır".
Nasıl çalışıyor?
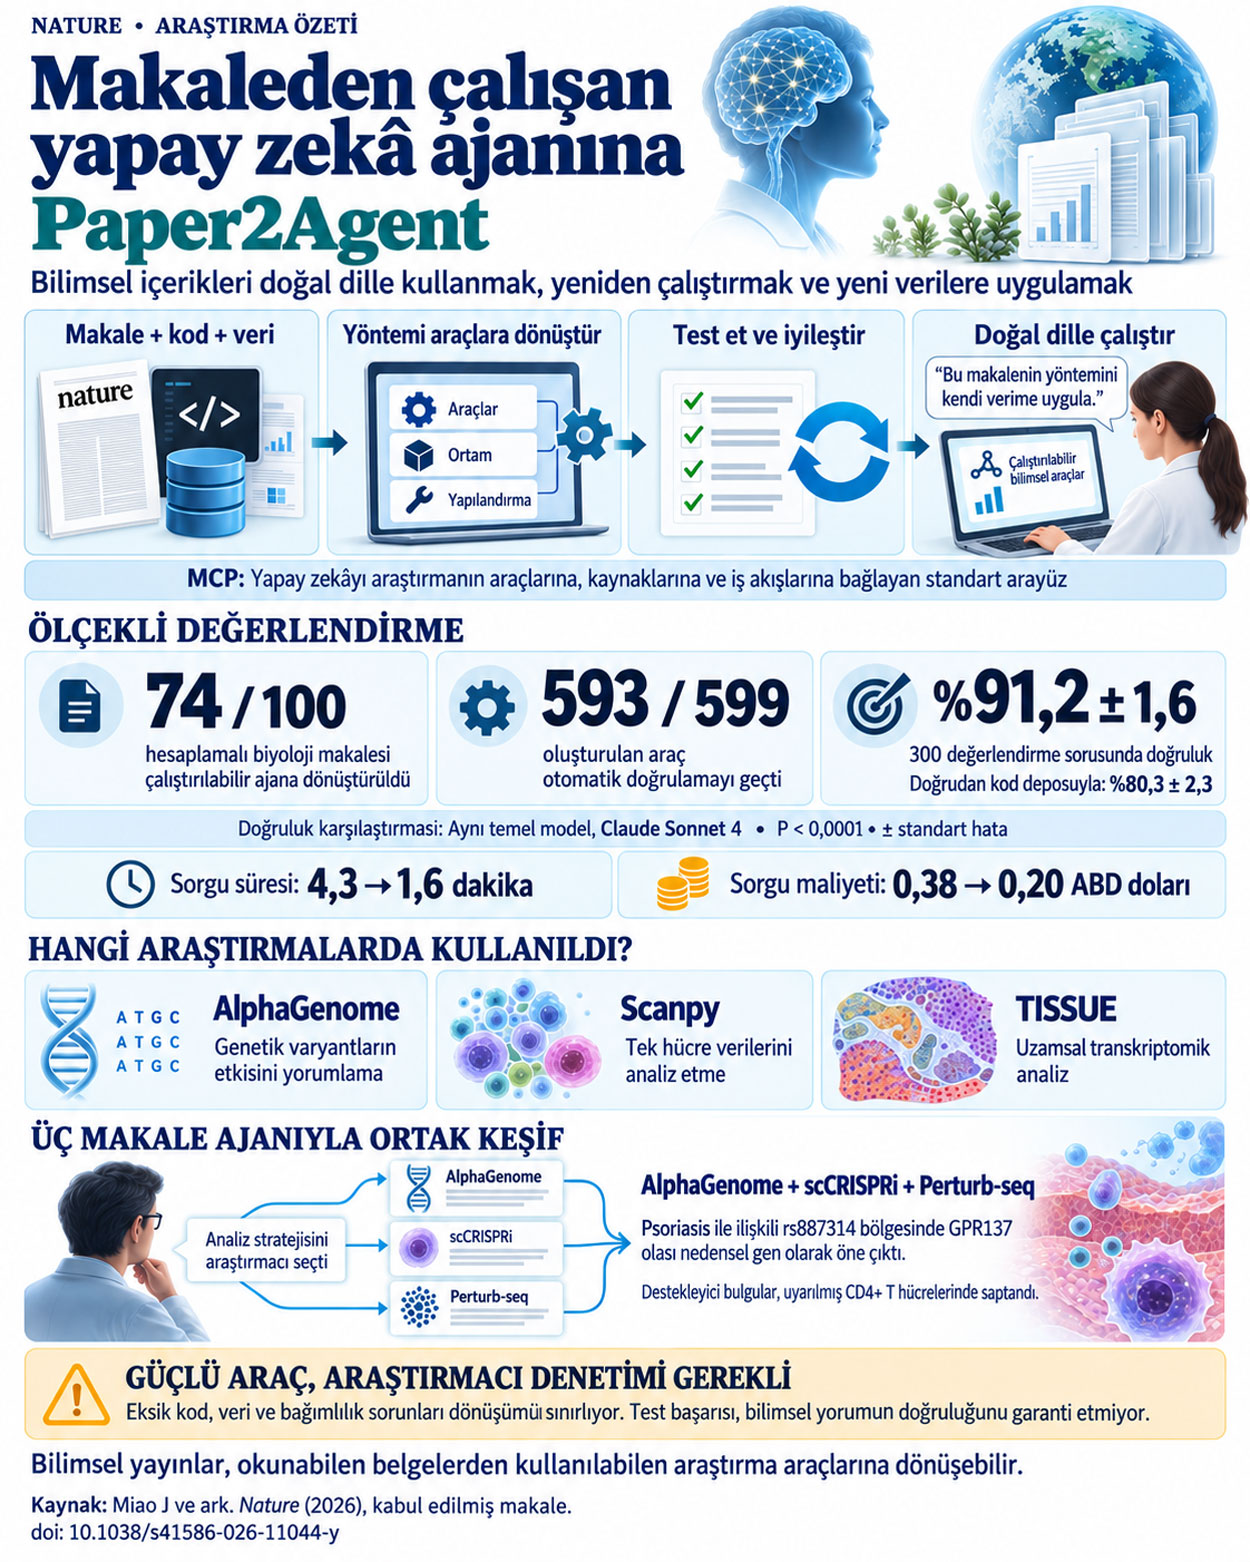
Paper2Agent, bir makaleyi dört adımda ajana çevirir. Süreç otomatiktir; insan müdahalesi gerektirmez.
| Adım | Ne yapılır |
|---|---|
| 1. Analiz | Makale metni, ek materyaller, veri setleri, kod deposu ve öğreticiler birlikte incelenir. Bunu birden fazla ajan paralel yapar |
| 2. Araç çıkarma | Koddaki işlevler, MCP araçlarına dönüştürülür. Her araç iyi tanımlanmış girdi parametreleri ve açıklamalarla donatılır |
| 3. Doğrulama | Kritik adım budur. Sistem, her araç için örnek verilerle test üretir ve çalıştırır; sonuçların tolerans sınırları içinde olup olmadığına ve üretilen şekillerin makaledeki şekillere uyup uymadığına bakar. Geçemeyen araçlar elenir ya da düzeltilir |
| 4. Paketleme | Doğrulanan araçlar ve çalışma ortamı, kilitlenerek bir MCP sunucusu halinde paketlenir. Her araç, makaledeki karşılığına kod referansı taşır |
MCP (Model Context Protocol) nedir? Bir yapay zekâ modelinin dış araçlara bağlanması için kullanılan standart bir protokoldür. Modeli bir bilgisayara, MCP sunucusunu da o bilgisayara takılan bir cihaz gibi düşünebilirsiniz: model, sunucunun sunduğu araçları doğal dille çağırıp çalıştırabilir. Paper2Agent'ın ürettiği şey tam olarak budur — her makale için bir MCP sunucusu. Bu sunucu, Claude Code gibi herhangi bir sohbet ajanına bağlanabilir.
Doğrulama adımı, bu çalışmayı benzerlerinden ayıran şeydir. "Makaleden kod üret" fikri yeni değil. Buradaki fark, üretilen her aracın çalıştırılarak ve makaledeki sonuçla karşılaştırılarak sınanması, ardından ortamın kilitlenmesidir. Kilitleme önemlidir: yarın bir kütüphane sürümü değiştiğinde araç bozulmaz. Bu, tekrarlanabilirliği tesadüfe bırakmamak demektir.
Ortaya çıkan ajan ne yapabiliyor?
- Makaleyle konuşmak: Yöntemi, varsayımları ve sınırları doğal dille sorabilirsiniz — sanki sorumlu yazara soruyormuşsunuz gibi.
- Makalenin sonuçlarını yeniden üretmek: "Şekil 3'ü yeniden oluştur" diyebilirsiniz.
- Yöntemi kendi verinize uygulamak: Asıl değer burada. Makaledeki analiz hattını kendi veri setinizde çalıştırabilirsiniz.
- Veri setlerini yeniden kullanmak: Makalenin verisine doğrudan sorular sorabilirsiniz.
- Başka makale ajanlarıyla birlikte çalışmak: Bir yöntem makalesinin ajanı, bir veri makalesinin ajanıyla konuşabilir.
Sonuçlar: ne kadar iyi çalışıyor?
Örnek 1: AlphaGenome ajanı
hepsi doğrulamayı geçti
kurulum süresi
kişisel bilgisayarda
| Soru tipi | Paper2Agent | Claude Code + doğrudan depo erişimi | Biomni |
|---|---|---|---|
| Öğreticiden türetilmiş 15 soru | %98,7 ± 1,3 | %82,7 ± 3,4 | %37,3 ± 4,0 |
| Yeni (öğreticide olmayan) 15 soru | %100,0 ± 0,0 | %78,7 ± 4,4 | %56,0 ± 3,4 |
| Araştırmacı tarzı 30 açık uçlu soru | %82,7 ± 2,4 | %56,7 ± 2,3 | %72,2 ± 2,2 |
Değerlendirme beş bağımsız çalıştırmayla yapılmış; puanlayıcılar arası uyum %96,7. Değerlendirme sırasında hiçbir yönteme el yazması ya da ham depo verilmemiş. Kazanımlar, soruların ifadesi değiştirildiğinde de korunmuş ve karşılaştırma kolu daha yeni bir modele yükseltildiğinde bile sürmüş.
Örnek 2: Scanpy ajanı
Scanpy, tek hücre transkriptomik analizinde yaygın kullanılan bir paket. Paper2Agent, en sık kullanılan işlevi (ön işleme ve kümeleme) için 7 araç üretmiş; hepsi doğrulamayı geçmiş, süreç yine yaklaşık 45 dakika ve 13 dolar sürmüş.
Burada çözülen ek bir sorun var: iş akışı sırası. Çok adımlı bir analizde adımların doğru sırayla yapılması gerekir. Bir yapay zekâ ajanının bu sırayı ya baştan "bilmesi" ya da kullanıcının onu dikkatle yazılmış bir komutla yönlendirmesi gerekir. Paper2Agent, sırayı MCP prompt'ları biçiminde makaleden doğrudan çıkarıp kodluyor — yani kullanıcının bilmesi gerekmiyor.
Büyük ölçekli değerlendirme: asıl sonuç burada
Yazarlar sistemi üç farklı makale kümesinde, hiçbir elle temizlik ya da müdahale yapmadan uçtan uca çalıştırmış.
| Küme | Sonuç |
|---|---|
| 100 hesaplamalı biyoloji makalesi | 74'ü başarıyla ajana dönüştürüldü. 599 araç önerildi, 593'ü doğrulamayı geçti |
| 300 öğretici temelli kıyaslama sorusu | Paper2Agent (Sonnet 4): %91,2 ± 1,6 Claude Code + doğrudan depo (Sonnet 4): %80,3 ± 2,3 (p<0,0001) Claude Code + doğrudan depo (Sonnet 4.6): %86,3 ± 1,1 (p<0,0001) |
| Sorgu başına maliyet ve süre | Paper2Agent: 0,20 $ ve 1,6 dakika Doğrudan model + depo: 0,38 $ ve 4,3 dakika |
| 10 biyoloji dışı makale yapay zekâ, istatistik, ekonometri, oyun kuramı, astrofizik | 42 çalıştırma görevinde %98,1 ± 0,8 — alan dışına genellenebildiğini gösteriyor |
| 26 veri ve keşif odaklı makale çalıştırılabilir kod yok | Yalnız kaynak katmanıyla, 100 sentez sorusunda %89,0 ± 3,1 Karşılaştırma (tarayıcı kullanan model): %82,0 ± 3,8 (p=0,03) Üstelik 34 kat daha ucuz ve 15 kat daha hızlı |
Sağlamlık testleri
| Test | Sonuç |
|---|---|
| Kapsam dışı soru reddi makaleler ve sorular karıştırılarak |
Paper2Agent kapsam dışı soruların %100'ünü doğru biçimde reddetti — yani kendi makalesinin dışındaki soruya "bilmiyorum" diyebiliyor |
| Depo bozulması testleri kasten bozulan bağımlılıklar, dosya yolları, yazım hataları, kullanımdan kalkmış API'ler |
Sistem bu arızalardan çalışır MCP sunucuları kurtarabildi |
| Öğreticisiz depo | Öğreticisi olmayan bir depodan da çalışan bir MCP üretilebildi — öğreticiler yararlı ama zorunlu değil |
| Kısayol öğrenme | Üretilen MCP'lerde sistematik "kısayol" (gerçek hesaplama yerine cevabı ezberleme) kanıtı bulunamadı |
Ajanların birlikte çalışması: sedef hastalığı örneği
Makalenin en iddialı bölümü bu. Yazarlar üç ayrı makale ajanını birbiriyle konuşturmuş: AlphaGenome (yöntem), MPRA bağlantılı tek hücre CRISPR girişimi (veri) ve CD4+ T hücrelerinde Perturb-seq (veri).
| Adım | Olan |
|---|---|
| Soru | Sedef hastalığıyla ilişkili rs887314 varyantı, CD4+ T hücrelerinde hangi gen üzerinden etki ediyor? |
| Tahmin | AlphaGenome ajanı GPR137 genini öne çıkardı (RNA dizileme nicelik skoru 0,997 — bölgedeki tüm genler arasında birinci) |
| İnsan müdahalesi | Yapay zekâ on doğrulama stratejisi önerdi; araştırmacı bunlardan birini seçti — imza korelasyonu analizi |
| Doğrulama | Ajan, varyantın bulunduğu düzenleyici bölgeyi bozmanın yarattığı gen ifade değişikliklerini, aday genlerin tek tek susturulmasıyla oluşan değişikliklerle karşılaştırdı |
| Sonuç | Yalnız GPR137 susturulması eşleşti: Spearman 0,613 (p=0,0038, 8 saat uyarım) ve 0,630 (p=0,0047, 48 saat uyarım). BAD ve diğer üç aday gen hiçbir koşulda eşleşmedi |
| Nüans | Dinlenme halinde eşleşme anlamlı değildi (Spearman 0,29; p=0,21) — yani etki hücrenin uyarılmasına bağlı. Bu, sedef hastalığında aktive CD4+ T hücrelerinin bilinen rolüyle uyumlu |
Burada dikkat çekici olan şey sonuç değil, yöntemin kendisi. Ajanın önerdiği doğrulama stratejisi — iki bağımsız perturbasyon veri setinin imzalarını birbiriyle korele etmek — kaynak makalelerin hiçbirinde önerilmemiştir. Yani ortaya yeni bir veri birleştirme yaklaşımı çıkmıştır. Ama yine de kararı insan vermiştir: yapay zekâ on seçenek önermiş, araştırmacı birini seçmiştir.
Asıl haber: 100 makalenin 26'sı ajana dönüştürülemedi
Bu çalışmanın en çok konuşulması gereken sayısı, en iyi performans değil — başarısızlık oranıdır.
biyoloji makalesi
| Neden | Anlamı |
|---|---|
| Çalıştırılabilir kodun bulunmaması | Makalede bir yöntem anlatılıyor ama onu çalıştıran kod ya yok ya erişilemiyor |
| Veri ya da model dosyalarının eksikliği | Kod var ama çalışması için gereken veri seti veya eğitilmiş model paylaşılmamış |
| Ortam ve bağımlılık hataları | Kod var, veri var, ama gereken kütüphane sürümleri belirtilmemiş ya da artık kurulamıyor |
| Genellenemeyen betikler | Kod yalnız yazarın kendi bilgisayarındaki tek bir duruma göre yazılmış; başka veriyle çalışmıyor |
| Eksik belgelendirme | Kodun ne yaptığı, hangi girdileri beklediği yazılı değil |
Yazarların kendi çıkarımı şudur — ve makalenin en önemli cümlesi olabilir:
"Bu zorluklar, bir makalenin ne kolaylıkla ajana dönüştürülebildiğinin başlı başına pratik bir tekrarlanabilirlik ölçütü olabileceğini düşündürmektedir."
Yani Paper2Agent, tasarlanma amacının yanında otomatik bir tekrarlanabilirlik denetçisine dönüşüyor. Bir makaleyi sisteme verirsiniz; çıktı üretemezse, sorun sistemde değil makaledededir. Ve bu denetim insan emeği gerektirmez, ölçeklenebilir ve öznel değildir.
Bunun neden önemli olduğu
Bilimde tekrarlanabilirlik krizi yıllardır konuşulan bir sorundur: yayımlanmış çalışmaların önemli bir bölümü, başkaları tarafından tekrarlanmaya çalışıldığında aynı sonucu vermez. Hesaplamalı bilimlerde bu sorunun özel bir biçimi vardır — sonuç "yanlış" olmayabilir, ama sonuca giden yol yeniden yürünemez: kod eksiktir, ortam kaybolmuştur, veri paylaşılmamıştır.
Bugüne kadar bunu ölçmenin tek yolu, birilerinin oturup elle denemesiydi — yavaş, pahalı ve az sayıda makaleyle sınırlı. Paper2Agent bunu otomatik ve ölçeklenebilir hale getiriyor.
Yazarların öngörüsü: Bugün birçok dergi "veri erişilebilirliği" ve "kod erişilebilirliği" bölümü istiyor. Yazarlar, buna bir "ajan erişilebilirliği" (agent availability) bölümünün ekleneceğini öngörüyor — yani makalenin katkısının etkileşimli bir ajan olarak da sunulup sunulmadığını belirten bir bölüm. Bu, yazarları çalışmalarını baştan "ajanlaştırılabilir" biçimde kurgulamaya teşvik edecektir.
Objektif değerlendirme: neyi ölçüyor, neyi ölçmüyor?
1. "Tekrarlanabilir" ile "doğru" aynı şey değildir
Bu, yazının en kritik uyarısıdır. Paper2Agent bir makalenin sonuçlarını kusursuzca yeniden üretebilir — ve makale yine de yanlış olabilir. Sistem, kodun çalıştığını ve çıktının makaledekiyle eşleştiğini doğrular. Yöntemin doğru yöntem olup olmadığını, istatistiğin uygun seçilip seçilmediğini, sonuçların aşırı yorumlanıp yorumlanmadığını denetlemez.
Hatalı bir analiz hattı da mükemmel biçimde tekrarlanabilir. Bu araç, bilimsel geçerliliği değil hesaplamalı sadakati ölçer. İkisini karıştırmak, "tekrarlanabilir olan doğrudur" gibi tehlikeli bir sonuca götürür.
2. Kıyaslamalar "sadık uygulama"yı ölçüyor, bilimsel isabeti değil
Yazarlar bunu kendileri belirtiyor ve dürüst bir ifadeyle yazıyorlar: açık uçlu analizlerde birden fazla savunulabilir cevap olabilir; bu nedenle tek bir referans cevapla uyuma dayalı kıyaslamalar "öncelikle sadık uygulamanın ölçütü olarak yorumlanmalıdır, analitik geçerliliğin değil".
Yani %91,2'lik doğruluk, "ajan bilimsel olarak doğru cevabı verdi" demek değil; "ajan, beklenen işlemi doğru biçimde yaptı" demektir. Bu ikisi arasındaki fark, özellikle açık uçlu araştırma sorularında büyür.
3. Başarısızlık nedenleri ayrıştırılmamış
26 makalenin ajana dönüştürülememesi çarpıcı bir bulgudur, ama her bir nedenin kaç makaleyi etkilediği bildirilmemiştir. "Kod hiç yok" ile "kütüphane sürümü eskimiş" aynı ağırlıkta sorunlar değildir: birincisi yazarın seçimidir, ikincisi zamanın doğal etkisidir. Bu ayrım yapılmadan, sayıyı bir tekrarlanabilirlik ölçütü olarak kullanmak eksik kalır.
Ayrıca 100 makalenin nasıl seçildiği, hangi dergilerden ve hangi yıllardan geldiği bu yazının dayandığı ana metinde ayrıntılı verilmemiştir (ek notlara bırakılmıştır). Seçim yöntemi, %74'lük oranın ne kadar genellenebilir olduğunu doğrudan etkiler.
4. Değerlendirmeyi geliştiriciler yapmış
Kıyaslama sorularını, referans cevapları ve puanlama ölçütlerini sistemi geliştiren ekip belirlemiştir. Puanlayıcılar arası uyumun %96,7 olması iyi bir işarettir, ama bağımsız bir grubun aynı testi tekrarlaması ayrı bir doğrulama olurdu. Bu, yeni araç makalelerinde yaygın ve kaçınılmaz bir sınırdır — ama sınır olmaktan çıkmaz.
5. Model bağımlılığı ve bakım yükü
- Sistem belirli bir yapay zekâ modeli ailesiyle çalıştırılmıştır. Model değiştiğinde sonuçların nasıl değişeceği kısmen test edilmiş ama tam olarak bilinmiyor.
- Yazarların kendi kabulüyle, makale ajanları da bakım gerektirir — tıpkı kod depoları gibi. Üst kaynak kod tabanı ve bağımlılıklar değiştikçe ajanın güncellenmesi gerekir. Yani "bir kere üret, sonsuza kadar çalışsın" değildir.
- Maliyet düşük ama sıfır değil: makale başına yaklaşık 13–14 dolar kurulum, sorgu başına 0,20 dolar.
6. Yorumlama hâlâ insanda
Yazarlar bu noktayı özellikle vurguluyor ve bu, aracın dürüst biçimde konumlandırıldığının işaretidir: "Hipotez üretimi ve mekanistik yorumlama dahil açık uçlu bilimsel akıl yürütme insan denetiminde kalır. Paper2Agent hipotez üretebilir, doğrulama stratejileri önerebilir ve analizleri ölçekte çalıştırabilir, ancak yönü seçmek ve kanıtı değerlendirmek araştırmacının sorumluluğundadır."
Ve kendi tanımlarını da net koyuyorlar: bu araç, "otonom ya da yetkili bir bilimsel sonuç kaynağı değil"; bilimsel keşfi güçlendiren ve makalelere erişimi, tekrarlanabilirliği ve yeniden kullanımı iyileştiren bir araçtır.
Tıp ve onkoloji okuru için ne anlama geliyor?
Kanıt değerlendirmesi için yeni bir sinyal
Bir çalışmayı değerlendirirken sorduğumuz sorulara bir yenisi eklenebilir: bu makalenin kodu ve verisi gerçekten çalışıyor mu? Bugüne kadar bunu denetlemek pratik değildi; otomatikleşirse, bir makalenin metodolojik ciddiyetine dair ölçülebilir bir gösterge olur.
Yeniden analiz kolaylaşır
Yazarların vurguladığı bir kullanım şekli şu: yayımlanmış bir sonucu, bağımsız bir model tabanlı kanıtla yeniden değerlendirmek. Tek bir komutla, yeni bir analiz hattı kurmadan. Ölçekte uygulanırsa, yayımlanmış sonuçları sistematik olarak yeniden gözden geçirmenin yolu açılır.
Klinik verilerle doğrudan ilgisi yok
Bu araç hesaplamalı yöntem makaleleri için tasarlanmıştır. Klinik çalışmaların çoğunda hasta verisi paylaşılamaz; dolayısıyla bir faz 3 çalışmasının "ajanlaştırılması" bu yaklaşımın kapsamı dışındadır. Biyoinformatik, genomik ve görüntü analizi alanlarında ise doğrudan uygulanabilir.
Bir uyarı daha. "Makaleyle konuşmak" fikri çekicidir ama bir riski vardır: okumanın yerine geçmesi. Bir makalenin sınırlarını, hasta seçimini, istatistiksel varsayımlarını ve nelerin ölçülmediğini anlamak, o makaleyle sohbet ederek değil okuyarak olur. Ajan size makalenin söylediğini söyler; makalenin söylemediğini fark etmek hâlâ okuyucunun işidir. Bu yazı dizisinde defalarca gördüğümüz gibi, bir çalışmanın en önemli kısmı çoğu zaman bildirilmeyen kısmıdır.
Sık sorulan sorular
- Paper2Agent tam olarak ne yapıyor?
- Bir bilimsel makaleyi — metnini, ek materyallerini, veri setlerini ve kod deposunu — otomatik olarak analiz edip, o makalenin yöntemlerini doğal dille çağırabileceğiniz araçlara dönüştürüyor. Sonuçta ortaya, makalenin "sanal sorumlu yazarı" gibi davranan bir yapay zekâ ajanı çıkıyor: yöntemini sorabilir, sonuçlarını yeniden ürettirebilir ve yöntemi kendi verinizde çalıştırabilirsiniz.
- Bu, makaleyi bir dil modeline okutmaktan farklı mı?
- Evet, temelden farklı. Bir dil modeline PDF verdiğinizde model metin üzerinden konuşur — koddaki analizi çalıştırmaz. Paper2Agent, koddaki işlevleri gerçekten çalıştırılabilir araçlara çeviriyor ve bunları örnek verilerle test edip doğruluyor. Kıyaslamalarda fark de burada görülüyor: doğrudan depo erişimi verilmiş bir modele göre doğruluk %80,3'ten %91,2'ye çıkıyor, üstelik sorgu başına maliyet ve süre neredeyse yarıya iniyor.
- "Makale tekrarlanabilir mi" testi nasıl yapılıyor?
- Aslında ayrı bir test değil — sistemin kendi çalışma biçiminin doğal bir yan ürünü. Paper2Agent bir makaleyi ajana çevirirken kodu çalıştırmak, veriyi bulmak ve ortamı kurmak zorunda. Bunlardan biri eksikse süreç başarısız olur. 100 hesaplamalı biyoloji makalesinden yalnız 74'ü dönüştürülebilmiş; kalan 26'sında kod yok, veri yok ya da ortam kurulamıyor. Yazarların kendi ifadesiyle, bir makalenin ne kolaylıkla ajana dönüştürülebildiği başlı başına bir tekrarlanabilirlik ölçütü olabilir.
- Yani ajana dönüştürülebilen bir makale doğru mudur?
- Kesinlikle hayır ve bu en önemli ayrımdır. Sistem, kodun çalıştığını ve çıktının makaledekiyle eşleştiğini doğrular — yöntemin doğru yöntem olup olmadığını, istatistiğin uygun seçilip seçilmediğini ya da sonuçların aşırı yorumlanıp yorumlanmadığını denetlemez. Hatalı bir analiz de kusursuz biçimde tekrarlanabilir. "Tekrarlanabilir" hesaplamalı sadakati, "doğru" ise bilimsel geçerliliği anlatır; ikisi farklı şeylerdir.
- Ne kadar sürüyor ve ne kadara mal oluyor?
- İki örnek çalışmada bir makaleyi ajana çevirmek yaklaşık 45 dakika ve 13–14 dolar sürmüş — kişisel bir bilgisayarda. Bu tek seferlik bir maliyet. Sonrasında her sorgu yaklaşık 0,20 dolar ve 1,6 dakika. Karşılaştırma olarak, aynı işi doğrudan modelle ve depoyla yapmak 0,38 dolar ve 4,3 dakika sürüyor.
- Yalnız biyoloji makaleleri için mi çalışıyor?
- Hayır. Yazarlar yapay zekâ, istatistik, ekonometri, oyun kuramı ve astrofizik alanlarından 10 makaleyi de denemiş; 42 çalıştırma görevinde %98,1 doğruluk elde etmişler. Ayrıca çalıştırılabilir kodu olmayan 26 veri ve keşif makalesinde, yalnız "kaynak katmanı" ile sentez sorularında %89,0 doğruluk sağlanmış.
- Ajanlar birbiriyle konuşabiliyor mu?
- Evet ve makalenin en iddialı gösterimi bu. Bir yöntem makalesinin ajanı (AlphaGenome) ile iki veri makalesinin ajanı birlikte çalıştırılarak, sedef hastalığıyla ilişkili bir genetik varyantın hangi gen üzerinden etki ettiği bulunmuş: GPR137. Üstelik ajanın önerdiği doğrulama yöntemi — iki bağımsız veri setinin imzalarını korele etmek — kaynak makalelerin hiçbirinde yer almıyor. Ama seçimi insan yapmış: ajan on strateji önermiş, araştırmacı birini seçmiş.
- Bu, makaleyi okumanın yerine geçer mi?
- Geçmemeli. Bir makalenin sınırlarını, hasta seçimini, istatistiksel varsayımlarını ve nelerin ölçülmediğini anlamak, o makaleyle sohbet ederek değil okuyarak olur. Ajan size makalenin söylediğini söyler; makalenin söylemediğini fark etmek hâlâ okuyucunun işidir. Ve bir çalışmanın en önemli kısmı çoğu zaman bildirilmeyen kısmıdır.
- Ajan yanlış cevap verirse ne olur? Uydurma riski var mı?
- Bu risk için iki önlem var. Birincisi: her araç, makaledeki karşılığına kod referansı taşıyor — yani cevabın nereden geldiği izlenebilir. İkincisi: kapsam dışı soru testinde sistem, kendi makalesiyle ilgisi olmayan soruların %100'ünü doğru biçimde reddetmiş. Yine de açık uçlu sorularda doğruluk %82,7'ye düşüyor; yani hata payı sıfır değil.
- Klinik çalışmalar için de kullanılabilir mi?
- Genellikle hayır. Bu araç hesaplamalı yöntem makaleleri için tasarlanmış. Klinik çalışmaların çoğunda hasta verisi gizlilik nedeniyle paylaşılamaz; dolayısıyla bir faz 3 çalışmasının ajanlaştırılması bu yaklaşımın kapsamı dışında. Biyoinformatik, genomik, görüntü analizi ve epidemiyolojik modelleme gibi kodun ve verinin paylaşılabildiği alanlarda ise doğrudan uygulanabilir.
- Bir kere kurulan ajan sonsuza kadar çalışır mı?
- Hayır. Yazarlar bunu açıkça belirtiyor: makale ajanları da tıpkı kod depoları gibi bakım gerektirir. Üst kaynak kod tabanları ve bağımlılıklar değiştikçe ajanın güncellenmesi gerekir. Sistem ortamı kilitleyerek bu sorunu azaltıyor ama tamamen ortadan kaldırmıyor.
- Dergiler bunu zorunlu tutar mı?
- Yazarlar öyle öngörüyor. Bugün birçok dergi "veri erişilebilirliği" ve "kod erişilebilirliği" bölümü istiyor; yazarlar buna bir "ajan erişilebilirliği" bölümünün ekleneceğini tahmin ediyor. Bu gerçekleşirse, araştırmacılar çalışmalarını baştan ajanlaştırılabilir biçimde kurgulamaya yönelecektir — ki bu, tekrarlanabilirlik açısından tek başına olumlu bir baskıdır.
Terimler sözlüğü
- Yapay zekâ ajanı (AI agent)
- Bir görev üzerine akıl yürütebilen ve amacına ulaşmak için dış araçları kullanarak eyleme geçebilen otonom sistem. Genellikle bir büyük dil modeli ile dış araçların birleşiminden oluşur.
- MCP (Model Context Protocol)
- Bir yapay zekâ modelinin dış araçlara bağlanması için kullanılan standart protokol. Paper2Agent'ın her makale için ürettiği şey bir MCP sunucusudur; bu sunucu herhangi bir sohbet ajanına takılabilir.
- MCP sunucusu
- Belirli araçları ve kaynakları bir yapay zekâ modeline sunan yazılım bileşeni. Makale ajanının "beyni" değil, "el aletleri çantası"dır.
- Tekrarlanabilirlik (reproducibility)
- Bir çalışmanın verisi ve yöntemi kullanılarak aynı sonuca yeniden ulaşılabilmesi. Doğrulukla aynı şey değildir: hatalı bir analiz de kusursuz biçimde tekrarlanabilir.
- Bağımlılık (dependency)
- Bir yazılımın çalışabilmesi için gereken diğer yazılım kütüphaneleri. Sürümleri belirtilmediğinde ya da zamanla değiştiğinde kod çalışmaz hale gelir — makalelerin ajana dönüştürülememesinin başlıca nedenlerinden biridir.
- Ortam kilitleme (environment locking)
- Bir kodun çalıştığı tüm kütüphane sürümlerinin kayıt altına alınıp sabitlenmesi. Paper2Agent bunu otomatik yaparak aracın gelecekte de çalışmasını güvence altına alır.
- Kıyaslama (benchmark)
- Bir sistemin performansını ölçmek için kullanılan standart soru kümesi. Bu çalışmada üç tip kullanılmış: öğreticiden türetilmiş, yeni ve açık uçlu araştırmacı tarzı sorular.
- Sadık uygulama (faithful execution)
- Bir sistemin beklenen işlemi doğru biçimde yapması. Bilimsel isabetle aynı şey değildir; yazarlar kıyaslama sonuçlarının öncelikle bu anlamda okunması gerektiğini belirtir.
- Kısayol öğrenme (shortcut learning)
- Bir sistemin gerçek hesaplamayı yapmak yerine beklenen cevabı ezberleyip doğrudan üretmesi. Yazarlar bu davranışın sistematik kanıtına rastlamadıklarını bildiriyor.
- Depo bozulması (repository drift)
- Bir kod deposunun zamanla bozulması: bağımlılıkların eskimesi, dosya yollarının değişmesi, API'lerin kullanımdan kalkması. Yazarlar bu arızaları kasten üreterek sistemi sınamıştır.
- Öğretici (tutorial)
- Bir yazılımın nasıl kullanılacağını örnekle gösteren belge. Paper2Agent bunlardan büyük ölçüde yararlanır, ama öğreticisi olmayan depolardan da çalışan ajan üretebildiği gösterilmiştir.
- GWAS (genom çapında ilişkilendirme çalışması)
- Bir hastalıkla ilişkili genetik varyantları genom genelinde tarayarak bulan yöntem. Bulunan varyantın hangi gen üzerinden etki ettiğini belirlemek ayrı ve zor bir problemdir — makaledeki sedef hastalığı örneği tam olarak budur.
- Tek hücre transkriptomiği
- Tek tek hücrelerin hangi genleri ne kadar ifade ettiğini ölçen yöntem. Scanpy, bu alanda yaygın kullanılan bir yazılımdır.
DROZDOGAN Akademi Yorumu
Bu bir onkoloji çalışması değil; bilimin nasıl yapıldığına ve nasıl denetlendiğine dair bir çalışma. Ama tam da bu yüzden, kanıt okumayı iş edinmiş herkesi ilgilendiriyor.
⚡ Bu çalışma neden önemli
İki nedenle. Birincisi pratik: bir yöntem makalesinin değeri kullanılmasındadır, ama makale formatı kullanmayı değil anlatmayı optimize eder. Paper2Agent bu boşluğu otomatikleştiriyor — 45 dakika ve 14 dolarla. İkincisi ve daha önemlisi: sistem, tasarlanma amacının yanında istemeden bir tekrarlanabilirlik denetçisine dönüşüyor. 100 makalenin 26'sının dönüştürülememesi, bu çalışmanın en çok konuşulması gereken sayısıdır.
✅ Güçlü olan taraf
Değerlendirme titiz kurulmuş: üç ayrı makale kümesi, beş bağımsız çalıştırma, puanlayıcılar arası %96,7 uyum, ve karşılaştırma kolları (doğrudan depo erişimli model, Biomni, tarayıcı kullanan model). Sağlamlık testleri de ciddi: kapsam dışı soruların %100'ünün reddedilmesi ve kasten bozulmuş depolardan kurtarma yapabilmesi, bu tür araçlarda seyrek görülen özenlerdir. Sedef hastalığı örneğinde ajanın kaynak makalelerde bulunmayan bir doğrulama stratejisi önermesi de gerçekten dikkat çekicidir. Ve en önemlisi: yazarlar aracı abartmıyor — "otonom ya da yetkili bir bilimsel sonuç kaynağı değil" diye kendileri yazıyor.
⚠️ Sınırlar ve dikkat edilmesi gerekenler
En kritik ayrım şu: tekrarlanabilir olan doğru değildir. Sistem kodun çalıştığını doğrular, yöntemin uygun olduğunu değil. Hatalı bir analiz hattı da kusursuzca tekrarlanır. Yazarlar bunu kısmen kabul ediyor: kıyaslamaların "sadık uygulamanın ölçütü olarak okunması, analitik geçerliliğin değil" gerektiğini kendileri yazıyor. Ayrıca 26 başarısız makalenin nedenleri ayrıştırılmamış — "kod hiç yok" ile "kütüphane sürümü eskimiş" aynı ağırlıkta sorunlar değil, ama aynı sayının içinde. 100 makalenin nasıl seçildiği de ana metinde ayrıntılı değil; bu, %74 oranının genellenebilirliğini doğrudan etkiler. Son olarak, kıyaslama sorularını ve puanlama ölçütlerini sistemi geliştiren ekip belirlemiştir.
🩺 Pratikte ne yapılmalı
1. Bir makaleyi değerlendirirken sorduğunuz sorulara birini ekleyin: kodu ve verisi gerçekten çalışıyor mu? Bu artık ölçülebilir bir şey.
2. "Bu makale tekrarlanabilir" ifadesini "bu makale doğru" diye okumayın; ikisi farklı şeylerdir.
3. Ajanla konuşmayı okumanın yerine değil, yanına koyun. Bir çalışmanın en önemli kısmı çoğu zaman bildirilmeyen kısmıdır ve bunu ajan size söylemez.
4. Kendi çalışmanızı yayımlıyorsanız, kodu ve veriyi başkasının çalıştırabileceği biçimde paylaşın — bağımlılık sürümleri dahil. Bu artık yalnız bir nezaket değil, ölçülen bir nitelik.
5. Klinik çalışmalarda bu yaklaşımın kapsamı sınırlıdır; hasta verisi paylaşılamaz. Biyoinformatik ve genomik tarafta ise doğrudan uygulanabilir.
❓ Henüz cevabı olmayan sorular
26 başarısız makalenin kaçı "kod hiç paylaşılmamış" yüzünden, kaçı "zamanla bozulmuş" yüzünden? Bu ayrım yapılmadan sayı bir denetim ölçütü olamaz. Bağımsız bir grup aynı kıyaslamayı tekrarlarsa aynı sonuçlar çıkar mı? Dergiler "ajan erişilebilirliği" bölümü istemeye başlarsa, yazarlar gerçekten daha iyi kod mu paylaşır yoksa yalnız kutuyu işaretlemeyi mi öğrenir? Ve en düşündürücü olanı: makalelerle konuşmak kolaylaştıkça, makaleleri okumak ne olacak?
Kısa hükmümüz: Paper2Agent'ın asıl katkısı, yöntem makalelerini kullanılabilir kılması değil — bir makalenin ne kadar sağlam kurulduğunu ölçülebilir hale getirmesidir. 100 makalenin 26'sının çalıştırılamaması, aracın başarısızlığı değil bulgusudur. Ama şu ayrım korunmalıdır: bu araç hesaplamalı sadakati denetler, bilimsel geçerliliği değil. Tekrarlanabilir olan her şey doğru değildir.
Şeffaflık notu. Bu yazı, Miao ve arkadaşlarının Nature dergisinde yayımlanan açık erişimli makalesinin tam metnine dayanmaktadır; tüm sayılar o metinden alınmıştır. Makalenin ek notlarına (Supplementary Note), ek şekillerine ve yöntemler bölümünün tamamına gidilmemiştir; bu nedenle 100 makalenin seçim ölçütleri, başarısızlık nedenlerinin makale başına dağılımı, ablasyon analizlerinin ayrıntıları ve DEHB üzerine ek vaka çalışması bu yazıya yansımamıştır. Sayılar ana metinde bildirildiği biçimde aktarılmıştır.
Eleştiriler kime ait? Kıyaslamaların "sadık uygulamayı ölçtüğü, analitik geçerliliği değil" tespiti, yorumlamanın insan denetiminde kalması gerektiği ve ajanların bakım gerektirdiği yazarların kendi ifadeleridir. Buna karşılık "tekrarlanabilir olan doğru değildir" vurgusu, başarısızlık nedenlerinin ayrıştırılmamış olması, makale seçim yönteminin ana metinde ayrıntılı verilmemesi, değerlendirmeyi geliştirici ekibin yapmış olması ve ajanla konuşmanın okumanın yerine geçme riski başlıklarındaki eleştiriler bize aittir.
Bu yazı bir yazılım aracını tanıtmaktadır; aracın kendisi tarafımızdan kullanılmamış ve bağımsız olarak sınanmamıştır. Anlatılan sistemin hiçbir klinik uygulaması yoktur ve hasta bakımına dair bir öneri içermez. Metin bilgilendirme amaçlıdır.
Kaynaklar
- Miao J, Davis JR, Zhang Y, Pritchard JK, Zou J. Reimagining research papers as interactive and reliable AI agents. Nature. 2026. DOI 10.1038/s41586-026-11044-y. (Açık erişim)
- Paper2Agent canlı demo ve belgeleri: paper2agent.ai
- Avsec Ž, ve ark. Advancing regulatory variant effect prediction with AlphaGenome. Nature.
- Wolf FA, Angerer P, Theis FJ. SCANPY: large-scale single-cell gene expression data analysis. Genome Biology.
- TISSUE: transcript imputation with spatial single-cell uncertainty estimation.
- MPRA bağlantılı tek hücre CRISPR girişimi (scCRISPRi) çalışması.
- CD4+ T hücrelerinde genom ölçekli Perturb-seq çalışması: bağlama özgü T hücre program düzenleyicileri.
- Model Context Protocol (MCP) teknik belgeleri.