Virtual Biotech – 37 Bin Yapay Zekâ Ajanının Kurduğu Sanal İlaç Şirketi
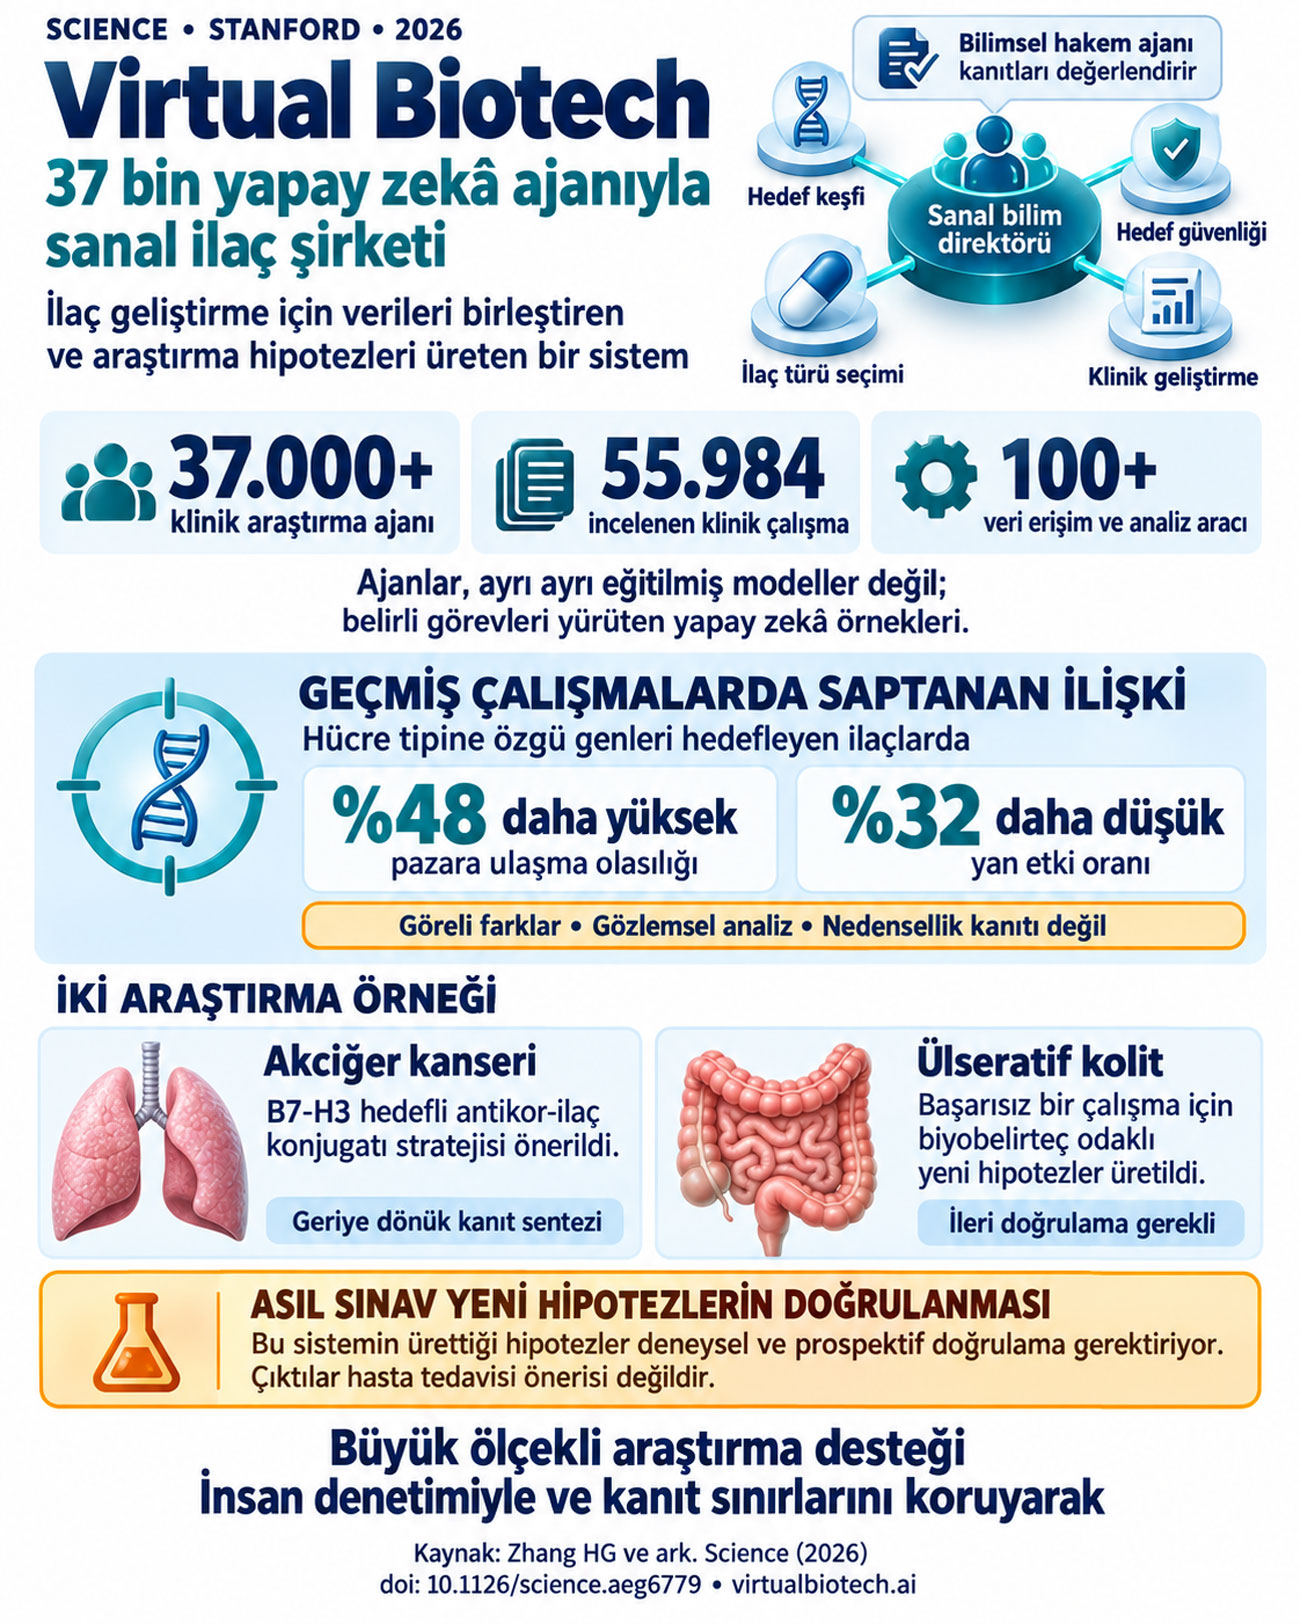
Stanford'dan bir ekip, gerçek bir ilaç şirketinin organizasyon şemasını taklit eden bir yapay zekâ sistemi kurdu: hedef keşfi, güvenlilik değerlendirmesi, ilaç formu seçimi ve klinik geliştirme bölümleri olan bir "sanal biyoteknoloji şirketi". Sistem 55.984 klinik çalışmayı tek tek okuyup sonuçlarını etiketledi ve bir sonuç bildirdi: hücre tipine özgü genleri hedefleyen ilaçlar pazara ulaşmada %48 daha başarılı, yan etkileri %32 daha az. Science'ta yayımlandı ve dünya basınında geniş yer buldu. Bu yazı hem sistemin ne yaptığını hem de bu sayıların ne kadarına güvenilebileceğini ele alıyor.
Baştan iki uyarı. Birincisi: bu çalışmanın hiçbir bulgusu deneysel olarak doğrulanmamıştır — Nature'ın haber servisi bunu açıkça yazıyor: tahminler "deneylerle doğrulanmamıştır, klinik çalışmalar bir yana". İkincisi: manşet olan %48'lik sayı gözlemsel bir ilişkidir, nedensellik değildir — ve karıştırıcı etkenler tam olarak denetlenmemiştir. Aşağıda ikisini de ayrıntılı ele alıyoruz.
| Başlık | "The Virtual Biotech: A multi-agent AI framework for therapeutic discovery and development" |
| Yazarlar | Harrison G. Zhang, Peter Eckmann, Jiacheng Miao, Andrew B. Mahon, James Zou |
| Kurum | Stanford Üniversitesi |
| Dergi | Science · 17 Eylül 2026 (ilk yayın) · DOI 10.1126/science.aeg6779 |
| Kod | Açık kaynak (MIT lisansı); proje sayfası virtualbiotech.ai |
| Altyapı | Claude Agent SDK; 100'den fazla özelleştirilmiş MCP ve analiz aracı |
| Not | Kıdemli yazar James Zou ve Jiacheng Miao, bir gün önce Nature'da yayımlanan Paper2Agent makalesinin de yazarlarıdır |
Sistem nasıl kurulmuş?
Fikir basit ama iddialı: bir ilaç şirketinde farklı uzmanlıklar farklı bölümlerde çalışır ve bir molekül bu bölümlerden sırayla geçer. Virtual Biotech bu yapıyı yapay zekâ ajanlarıyla yeniden kurmuş.
| Bölüm | İşlevi |
|---|---|
| Hedef Belirleme | Hangi genin ya da proteinin hedeflenmesi gerektiğini araştırır |
| Hedef Güvenliği | O hedefi bloke etmenin hangi yan etkileri doğurabileceğini değerlendirir |
| Form Seçimi | İlacın küçük molekül mü, antikor mu, antikor-ilaç konjugatı mı olması gerektiğine bakar |
| Klinik Yöneticiler | Klinik çalışma tasarımı ve sonuçlarını değerlendirir |
Bunların üzerinde bir sanal bilim direktörü (CSO) ajanı duruyor: gelen soruyu alt sorulara bölüp uzmanlara dağıtıyor ve dönen sonuçlar üzerinden akıl yürütüyor. Ayrı bir bilimsel hakem ajanı ise sonuçları eleştiriyor ve eksik kanıtları işaretliyor — sentez yapılmadan önce bir geri bildirim döngüsü çalışıyor.
| Bileşen | Ölçek |
|---|---|
| Adlandırılmış uzman ajan | 11 (genomik analisti, tek hücre analisti, FDA güvenlilik sorumlusu, klinik araştırmacı, tıbbi kimyager, bilimsel hakem ve diğerleri) |
| Geçici klinik araştırmacı ajanı | 37.075 — çalışma başına yaklaşık bir tane, paralel çalıştırıldı |
| Bağlandığı veri tabanları | Open Targets, CELLxGENE Census, Tabula Sapiens, DepMap, Reactome, ClinicalTrials.gov, cBioPortal, GTEx, FDA düzenleyici belgeleri ve diğerleri |
| Kapsam | 78.726 hedef · 39.530 hastalık · 14,5 milyon protein–protein etkileşimi · 100 milyondan fazla tek hücre profili |
"Ajan" burada ne demek? Bir büyük dil modelinin, dış araçlara (veri tabanları, analiz yazılımları) bağlanıp bir görevi kendi başına yürütebilen hali. 37 bin ajan demek, 37 bin ayrı yapay zekâ modeli demek değil; aynı modelin, her biri tek bir klinik çalışmayı okumakla görevlendirilmiş 37 bin paralel örneği demek. İşin büyüklüğü buradan geliyor: bir insanın aylar süreceği bir tarama, paralel çalıştırılarak kısaltılıyor.
Doğrulanamadı — ve dolaşan bir sayıyı düzeltmek gerekiyor. "55 bin çalışma 5 günde tarandı" biçiminde aktarılan bir bilgi dolaşıyor; bu sayıyı hiçbir kaynakta bulamadık. Makalenin kendisi analizin ne kadar sürdüğünü ve ne kadara mal olduğunu bildirmiyor. Bir ikincil haber kaynağı "yaklaşık 6 saat" diyor, ama bu da makaleden değil. Makalede yalnız iki vaka çalışmasının maliyeti veriliyor: 46 ve 54 dolar. Süre konusunda kesin bir şey söylememek en doğrusu.
Ayrıca makale hangi modelin kullanıldığını "Claude" diyerek geçiyor ve eğitim bilgi kesimini Ocak 2025 olarak belirtiyor; kod deposundaki varsayılan ayarlar ise daha yeni bir model gösteriyor. Bu ikisi tam örtüşmüyor.
Birinci gösterim: 55.984 klinik çalışmanın taranması
Sistem, ClinicalTrials.gov üzerindeki yaklaşık 56 bin çalışmayı okuyup her birinin sonucunu etiketlemiş: birincil sonlanım karşılandı mı, ikincil sonlanımlar ne oldu, yan etki oranları neydi.
| Faz | Çalışma sayısı |
|---|---|
| Faz I | 14.237 |
| Faz II | 22.164 |
| Faz III | 14.911 |
| Faz IV | 4.672 |
| Toplam | 55.984 |
Sorulan soru: hangi hedefler daha başarılı?
Araştırmacılar, her ilacın hedeflediği geni iki ölçütle sınıflandırmış:
| Ölçüt | Ne anlatıyor |
|---|---|
| Hücre tipine özgülük (tau indeksi) | Gen vücutta her yerde mi çalışıyor, yoksa yalnız belirli bir hücre tipinde mi? Değer 1'e yaklaştıkça özgüllük artar |
| Anahtar benzeri ifade (bimodalite katsayısı) | Gen "az ya da çok" şeklinde kademeli mi çalışıyor, yoksa açık–kapalı gibi iki uçlu mu? İkincisi "anahtar benzeri" sayılıyor |
Fikrin mantığı şu: Vücudun her hücresinde çalışan bir geni bloke ederseniz, hedeflediğiniz hastalıklı dokuyla birlikte sağlıklı dokuları da etkilersiniz — yan etki kaçınılmaz olur. Buna karşılık yalnız belirli bir hücre tipinde çalışan bir geni hedeflerseniz, etki o hücreyle sınırlı kalır. Bu, ilaç geliştirmede uzun süredir sezgisel olarak bilinen bir ilkedir; bu çalışma onu 56 bin klinik çalışma üzerinde ölçmeyi deniyor.
Bulunan sonuçlar
| Sonlanım | Bildirilen etki | Olasılık oranı (OR) ve güven aralığı |
|---|---|---|
| Faz I'den Faz II'ye geçme | %40 daha olası | OR 1,27 (%95 GA 1,22–1,33) |
| Faz I'den Faz II'ye geçme (anahtar benzeri ölçütü) | — | OR 1,18 (1,13–1,23) |
| Pazara ulaşma | %48 daha olası | Olasılık oranı ve güven aralığı bildirilmemiş |
| Yan etki oranı | %32 daha düşük | Güven aralığı bildirilmemiş |
| Birincil sonlanımı karşılama | — | OR 1,11 (1,09–1,14) |
| İkincil sonlanımı karşılama | — | OR 1,12 (1,10–1,14) |
Bu tabloda iki şey hemen göze çarpıyor.
Birincisi: Manşet olan iki sayının — %48 ve %32 — güven aralığı yoktur. Çıplak yüzdeler olarak verilmişlerdir. Bir gözlemsel analizde etkinin ne kadar kesin ölçüldüğünü gösteren şey güven aralığıdır; onsuz bir yüzde, ne kadar güvenilir olduğu bilinmeyen bir sayıdır.
İkincisi: Faz I→II geçişi için olasılık oranı 1,27 olarak verilirken, aynı bulgu metinde "%40 daha olası" diye anlatılıyor. Bu iki ifade olasılık ölçeğinde birbirini tutmaz. Muhtemelen farklı bir ölçeğe dönüştürülmüş ya da biraz farklı bir modelden gelen bir sayıdır, ama bu belirtilmemiştir.
İkinci gösterim: akciğer kanserinde B7-H3 stratejisi
Bu bölüm, bu sitenin okurları için en ilgi çekici olanı — çünkü doğrudan akciğer kanseri ve bu yıl kongrelerin yıldızı olan bir hedef hakkında.
| Öneri | |
|---|---|
| Hastalık | Akciğer adenokarsinomu (LUAD) ve küçük hücreli akciğer kanseri (SCLC) |
| Hedef | B7-H3 (CD276) — bir bağışıklık kontrol noktası proteini |
| Mekanistik bulgu | Artışın fibroblastlarda yoğunlaştığı: SCLC'de log2 kat değişimi 1,94 (FDR p=3,0×10⁻⁶); LUAD'da 1,46 (FDR p=1,1×10⁻⁷) |
| Önerilen ilaç formu | Antikor-ilaç konjugatı (ADC) — hücre yüzeyinde bulunması ve hücre içi keseciklere taşınması gerekçesiyle; HER2 pozitif meme kanserindeki trastuzumab derukstekan açıkça örnek gösterilmiş |
| Destekleyici analiz 1 | TCGA akciğer adenokarsinomu verisinde (n=566) yüksek B7-H3, hastalığa özgü sağkalımda kötü gidişle ilişkili: HR 1,82 (%95 GA 1,06–3,15); p=0,031 (yaş, evre ve cinsiyete göre düzeltilmiş) |
| Destekleyici analiz 2 | 12 hastadan yaklaşık 65.000 doku noktasında uzamsal transkriptomik: B7-H3 yüksek bölgelerde komşu bağışıklık hücrelerinin belirgin azaldığı |
Ve işte tartışmalı kısım: "doğrulama". Sistem B7-H3'ü hedef, ADC'yi de form olarak önerdikten sonra araştırmacılar şunu gösteriyor: ifinatamab derukstekan adlı bir B7-H3 hedefli ADC, Ağustos 2025'te küçük hücreli akciğer kanserinde FDA'dan çığır açan tedavi statüsü almıştır — ve bu tarih, modelin bilgi kesim tarihi olan Ocak 2025'ten sonradır. Basında bu, "bağımsız dış doğrulama" olarak sunuldu.
Bu doğrulama iddiası dikkatle okunmalıdır ve üç sorun taşır.
1. Prospektif değil. Araştırma ekibinin kendisi de bunu kabul ediyor: çalışma, sistemin o programı önceden öngördüğünü ortaya koymuyor. Analiz, sonuç zaten bilinirken yapılmıştır.
2. Bilgi kesimi argümanı sağlam değil. B7-H3 hedefli antikor-ilaç konjugatları Ocak 2025'ten çok önce de son derece aktif ve yoğun konuşulan bir alandı. Modelin eğitim verisinde bu alanın hareketli olduğuna dair bol miktarda sinyal bulunması beklenir. Bilgi kesim tarihinden sonra bir onay gelmesi, öngörünün model tarafından üretildiğini kanıtlamaz.
3. Zaten en beklenen cevap. "Küçük hücreli akciğer kanserinde B7-H3'ü ADC ile hedefle" önerisi, 2024–2025 döneminde bu alanı takip eden herhangi bir onkoloğun vereceği cevaptı. Bir sistemi, alanın zaten bildiği bir cevabı ürettiği için doğrulanmış saymak, sınavın cevaplarını bilerek sınava girmeye benzer.
Not düşmek gerekir ki B7-H3 gerçekten iyi bir hedef çıktı. Eylül 2026'daki Dünya Akciğer Kanseri Kongresi'nde, nükseden küçük hücreli akciğer kanserinde iki ayrı B7-H3 antikor-ilaç konjugatı faz 3 çalışmalarda topotekanı yendi — biri 18,5'e karşı 10,3 aylık, diğeri 13,3'e karşı 9,4 aylık genel sağkalımla. Yani hedefin değeri artık randomize kanıtla gösterilmiştir. Ama bu, sistemin öngörüsünün değil, alanın doğrulanmasıdır. İki şey karıştırılmamalıdır.
Üçüncü gösterim: başarısız olmuş bir çalışmanın otopsisi
| Bilgi | |
|---|---|
| İlaç | Viksarelimab — OSMRβ'yi hedefleyen, sınıfının ilk monoklonal antikoru |
| Hastalık | Ülseratif kolit |
| Çalışma | MOONGLOW (NCT06137183) — Ağustos 2025'te sonlandırıldı, 79 hasta alındıktan sonra, ara yararsızlık analizi üzerine. Ciddi yan etki bildirilmemiş |
| Sistemin çıkardığı başarısızlık nedeni | "Kesin tıp boşluğu": ilaç, OSMR ifadesine göre zenginleştirilmemiş, seçilmemiş bir hasta grubunda denenmişti |
| Destekleyici kanıt | Bağımsız bir veri setinde OSMR ifadesi, yalnız tedaviye yanıt vermeyenlerde üç fibroblast alt durumunda belirgin artmış. Ayrıca anti-TNF, anti-IL-12/23 ve anti-integrin çalışmalarında da yanıt vermeyenlerin başlangıç OSMR düzeyi tutarlı biçimde daha yüksek çıkmış |
| Önerilen çözüm | OSMR yüksek hastaları seçerek biyobelirteç yönlendirmeli hasta alımı ve önceden tanımlanmış bir hedef tutulumu sonlanımı |
Bu bölümün güçlü yanı: Üç farklı biyolojik ilaç sınıfında aynı örüntünün tekrarlanması — yanıt vermeyenlerde OSMR'nin yüksek olması — rastlantıyla açıklanması zor bir bulgudur ve gerçekten ilgi çekicidir.
Zayıf yanı: Bu, sonucu bilinen bir başarısızlığın sonradan açıklanmasıdır. Sisteme, negatif sonucu çoktan kamuoyuna açıklanmış bir çalışma gösterilmiş ve "neden başarısız oldu" diye sorulmuştur. Bilim tarihinde başarısız çalışmalara sonradan makul açıklama üretmek hiç zor olmamıştır. Asıl sınav, sistemin henüz sonuçlanmamış çalışmalar için hangi tahminleri yaptığı ve bunların ne kadarının tuttuğu olurdu — bu yapılmamıştır.
Objektif değerlendirme: bu sayılara ne kadar güvenebiliriz?
1. Karıştırıcı etkenler tam denetlenmemiş
Bu, çalışmanın en ciddi metodolojik sorunudur. Manşet bulgu — "hücre tipine özgü hedefler daha başarılı" — gözlemsel bir ilişkidir. Böyle bir ilişkinin gerçek mi yoksa başka bir farkın yansıması mı olduğunu anlamak için karıştırıcı etkenlerin denetlenmesi gerekir.
Yazarlar faz, hasta alım yılı, tedavi alanı ve ilaç formu için düzeltme yaptıklarını belirtiyor. Ancak:
- Tedavi alanı yalnız "rastgele etki" olarak modele girmiş. Bu, alanlar arasındaki ortalama başarı farkını soğurur — ama asıl soruyu yanıtlamaz: bu ilişki büyük ölçüde onkolojiden mi geliyor? Onkolojiye özgü ya da onkoloji dışlanarak yapılmış bir duyarlılık analizi bildirilmemiştir.
- Sponsor tipi düzeltilmemiş. Yazarlar "sponsorla ilgili etkileri" olası karıştırıcılar arasında sayıyor, ama tanımladıkları modellerde sponsor yer almıyor. Oysa büyük ilaç şirketlerinin yürüttüğü çalışmaların pazara ulaşma olasılığı, küçük biyoteknoloji şirketlerininkinden sistematik olarak farklıdır.
2. Ters nedensellik tartışılmamış
Bu, makalede hiç ele alınmayan ve bize göre en güçlü alternatif açıklamadır.
Bir genin "hücre tipine özgü" olduğunu bilmek, o gen üzerinde ne kadar çalışıldığına bağlıdır. İyi çalışılmış, çok sayıda tek hücre analizine konu olmuş genler, aynı zamanda ilaç geliştirme açısından da daha olgun ve daha iyi anlaşılmış hedeflerdir. Yani ilişki şu yönde de olabilir: başarılı hedefler daha çok çalışıldığı için hücre tipine özgü oldukları daha net bilinmektedir — özgüllükleri onları başarılı yapmamıştır, başarılı olmaları özgüllüklerinin bilinmesini sağlamıştır.
Bu ihtimali dışlamak için, hedefin ne kadar çalışıldığını ölçen bir değişkenin (yayın sayısı, veri yoğunluğu gibi) modele katılması gerekirdi. Bildirilmemiştir.
3. Etki büyüklüğü göreli veriliyor, mutlak değil
"%48 daha olası" kulağa çok büyük gelir. Ama bu göreli bir artıştır ve mutlak karşılığını bilmeden yorumlanamaz. İlaç geliştirmede bilinen temel başarı oranları şöyledir:
| Geçiş | Başarı oranı |
|---|---|
| Faz II → Faz III | %31 — en dar boğaz |
| Faz III programlarının başvuruya dönüşmemesi | %40'tan fazlası başvuruya ulaşamıyor |
| Başvuru → onay | %86 (ilk değerlendirmede %61) |
| Faz I'den onaya, onkolojide | yaklaşık %5 |
| Faz I'den onaya, hematolojide | yaklaşık %26 (en yüksek alan) |
Kaba bir çeviri yapalım (bu hesap bizimdir, makalenin değil): Faz I'den Faz II'ye geçişte temel oran yaklaşık %52 kabul edilirse, 1,27'lik bir olasılık oranı bunu yaklaşık %58'e taşır — yani 6 puanlık bir artış. Faz I'den onaya giden yolda genel oran yaklaşık %8 kabul edilirse, benzer büyüklükte bir etki bunu yaklaşık %11'e çıkarır — 3 puanlık bir artış.
Bu gerçek ve bir ilaç portföyünü önceliklendirirken ekonomik olarak anlamlı bir farktır. Ama sektörün asıl sorunu olan %90'ın üzerindeki başarısızlık oranını çözmez. "%48 daha olası" ile "3 puan daha olası" aynı gerçeği anlatır; ilki manşet olur, ikincisi karar verdirir.
4. Doğrulama tarafı zayıf
| Yapılanlar | Yapılmayanlar |
|---|---|
| 100 çalışmanın elle denetimi: birincil sonlanımlarda %89,7, ikincil sonlanımlarda %83,9, yan etki oranlarında %92,4 isabet | Ayrılmış test kümesi yok |
| Bağımsız bir veri tabanıyla çakışan 7.278 çalışmada %85,3 uyum | Ablasyon analizi yok — hangi bileşenin ne kadar katkı yaptığı bilinmiyor |
| 1.000 yinelemeli permütasyon testi | Basit bir dil modeliyle karşılaştırma yok |
| Genetik kanıtı olmayan çalışmalarda (%74,6) etkinin korunduğunun gösterilmesi | Tek ajanlı ya da ajansız istatistiksel bir hatla karşılaştırma yok |
| — | Hiçbir prospektif doğrulama yok |
Elle denetim sayıları aslında iyidir ve çalışmanın en sağlam tarafıdır. Ancak yalnız ham uyum oranı bildirilmiş, şansa bağlı uyumu düzelten bir istatistik (Cohen kappa gibi) verilmemiştir. Sonuçların dengesiz dağıldığı durumlarda ham uyum performansı olduğundan iyi gösterir.
Ve en önemlisi: Nature'ın haber servisi durumu açıkça özetliyor — tahminler "deneylerle doğrulanmamıştır, klinik çalışmalar bir yana" ve sistem "gerçek dünya ilaç keşfinin potasında sınanmamıştır". Yazarlar da bunu kabul ediyor: sonuçlar "hâlâ deneysel olarak doğrulanmalıdır" ve sistem "az çalışılmış hastalıklar ve hedefler için henüz uygun değildir".
5. Hata yayılımı riski — yazarların kendi uyarısı
Makalede yer alan ve altı çizilmeyi hak eden bir cümle var: "Yapay zekâ ajanları analiz ya da yorumlama hataları yapabilir... tek bir hata sanal organizasyon boyunca yayılabilir."
Bu, çok ajanlı sistemlerin yapısal riskidir. On bir uzman ajanın üst üste bindiği bir yapıda, alt basamaktaki bir hata üst basamaklarda düzeltilmek yerine meşrulaşabilir — çünkü üst ajanlar alt ajanın çıktısını veri olarak alır. Bilimsel hakem ajanı bu riski azaltmak için konulmuş, ama tamamen ortadan kaldırdığını gösteren bir ölçüm yoktur.
6. Bağımsız eleştiri henüz yok
Bu yazının hazırlandığı tarihte makale yayımlanalı iki gün olmuştu. Basında geniş yer buldu, ancak haberlerin neredeyse tamamı tanıtıcı nitelikteydi. Nature'ın haberi çekince içeren tek metindi, ama "diğer bilim insanları" diyerek hiçbir eleştirmeni adıyla anmadı ve alıntılamadı. Science'ta eşlik eden bir değerlendirme yazısı bulunmamaktadır. Yani bu çalışma henüz alanın bağımsız süzgecinden geçmemiştir.
Sık sorulan sorular
- 37 bin yapay zekâ ajanı ne demek? Gerçekten 37 bin ayrı program mı?
- Hayır. 37.075 ajan, aynı modelin paralel çalıştırılan örnekleridir — her biri tek bir klinik çalışmayı okuyup sonucunu etiketlemekle görevlendirilmiş. Bunların yanında 11 adlandırılmış uzman ajan var: genomik analisti, tek hücre analisti, FDA güvenlilik sorumlusu, tıbbi kimyager, bilimsel hakem ve diğerleri. Asıl mimari bu 11 uzman ve onları yöneten bir "bilim direktörü" ajanıdır.
- "5 günde 50 bin çalışma tarandı" doğru mu?
- Bu sayıyı hiçbir kaynakta bulamadık ve makalenin kendisi analizin ne kadar sürdüğünü bildirmiyor. Bir ikincil haber kaynağı "yaklaşık 6 saat" diyor ama bu da makaleden gelmiyor. Makalede yalnız iki vaka çalışmasının maliyeti veriliyor: 46 ve 54 dolar. Süre konusunda kesin konuşmamak en doğrusu. Taranan çalışma sayısı ise net: 55.984.
- "Hücre tipine özgü genleri hedeflemek %48 daha başarılı" — bu güvenilir mi?
- Bulgu ilginç ama üç çekince var. Birincisi: bu gözlemsel bir ilişkidir, nedensellik değil. İkincisi: karıştırıcı etkenler tam denetlenmemiş — tedavi alanı yalnız rastgele etki olarak modele girmiş, onkolojiye özgü bir duyarlılık analizi yok, ve sponsor tipi (büyük ilaç şirketi mi, küçük biyoteknoloji mi) hiç düzeltilmemiş. Üçüncüsü: bu iki manşet sayının güven aralığı bildirilmemiştir — çıplak yüzdeler olarak verilmişlerdir.
- "Ters nedensellik" ne demek, burada neden önemli?
- Şu ihtimali anlatıyor: bir genin hücre tipine özgü olduğunu bilmek, o gen üzerinde ne kadar çalışıldığına bağlıdır. İyi çalışılmış genler hem daha iyi karakterize edilmiştir hem de ilaç geliştirme açısından daha olgundur. Yani ilişki ters yönde de olabilir — özgüllük başarıyı getirmemiş, başarı özgüllüğün bilinmesini sağlamış olabilir. Bu ihtimal makalede hiç tartışılmıyor.
- %48 ne kadar büyük bir fark?
- Göreli olarak büyük, mutlak olarak ölçülü. Kaba bir çeviriyle: Faz I'den Faz II'ye geçişte temel oran yaklaşık %52 kabul edilirse, bildirilen etki bunu yaklaşık %58'e taşır — 6 puanlık bir artış. Faz I'den onaya giden yolda genel oran yaklaşık %8'ken yaklaşık %11'e çıkar — 3 puan. Bir ilaç portföyünü önceliklendirirken anlamlı, ama sektörün %90'ın üzerindeki başarısızlık oranını çözmüyor.
- Akciğer kanseri önerisi gerçekten doğrulandı mı?
- Dikkatli okumak gerekiyor. Sistem B7-H3 hedefini ve antikor-ilaç konjugatı formunu önerdi; ardından araştırmacılar, bu hedefli bir ADC'nin Ağustos 2025'te FDA'dan çığır açan tedavi statüsü aldığını — yani modelin bilgi kesim tarihinden sonra — gösterdiler. Ama: bu prospektif bir öngörü değil, ekibin kendisi de bunu kabul ediyor; B7-H3 ADC'leri zaten Ocak 2025'ten çok önce son derece aktif bir alandı; ve bu öneri o dönemde alanı takip eden herhangi bir onkoloğun vereceği cevaptı. Hedefin değerli çıkması sistemi doğrulamaz.
- B7-H3 gerçekten iyi bir hedef mi peki?
- Evet, ve bu artık randomize kanıtla gösterilmiştir. Eylül 2026'daki Dünya Akciğer Kanseri Kongresi'nde nükseden küçük hücreli akciğer kanserinde iki ayrı B7-H3 antikor-ilaç konjugatı faz 3'te topotekanı yendi; genel sağkalım 18,5'e karşı 10,3 ay ve 13,3'e karşı 9,4 ay. Ama bu, alanın doğrulanmasıdır — sistemin öngörüsünün değil. İkisi karıştırılmamalıdır.
- Başarısız olmuş çalışmanın analizi değerli değil mi?
- Kısmen. Üç farklı biyolojik ilaç sınıfında aynı örüntünün çıkması — tedaviye yanıt vermeyenlerde OSMR düzeyinin yüksek olması — rastlantıyla açıklanması zor, gerçekten ilgi çekici bir bulgudur. Ama bu, sonucu zaten kamuoyuna açıklanmış bir başarısızlığın sonradan açıklanmasıdır. Bilimde başarısız çalışmalara sonradan makul açıklama üretmek hiç zor olmamıştır. Asıl sınav, henüz sonuçlanmamış çalışmalar için yapılan tahminlerin ne kadarının tuttuğu olurdu.
- Sistem hiç deneysel olarak sınandı mı?
- Hayır. Nature'ın haber servisi durumu açıkça yazıyor: tahminler "deneylerle doğrulanmamıştır, klinik çalışmalar bir yana" ve sistem "gerçek dünya ilaç keşfinin potasında sınanmamıştır". Yazarlar da bunu kabul ediyor ve sonraki adımı "platformun ürettiği hipotezleri deneysel laboratuvarlara taşımak" olarak tanımlıyor.
- Ajanların çalışmaları okuyup etiketlemesi ne kadar isabetli?
- Bu, çalışmanın en sağlam tarafı. 100 çalışmanın elle denetiminde birincil sonlanımlarda %89,7, ikincil sonlanımlarda %83,9, yan etki oranlarında %92,4 isabet bulunmuş. Ayrı bir veri tabanıyla çakışan 7.278 çalışmada uyum %85,3. Tek eksik: yalnız ham uyum oranı bildirilmiş, şansa bağlı uyumu düzelten bir istatistik verilmemiş — bu, sonuçların dengesiz dağıldığı durumlarda performansı olduğundan iyi gösterir.
- Çok ajanlı sistemlerin özel bir riski var mı?
- Evet ve yazarlar bunu kendileri yazıyor: "Yapay zekâ ajanları analiz ya da yorumlama hataları yapabilir; tek bir hata sanal organizasyon boyunca yayılabilir." On bir uzman ajanın üst üste bindiği bir yapıda, alt basamaktaki bir hata üst basamaklarda düzeltilmek yerine meşrulaşabilir — çünkü üst ajanlar alt ajanın çıktısını veri olarak alır. Bir "bilimsel hakem" ajanı bu riski azaltmak için konulmuş, ama ne kadar azalttığını gösteren bir ölçüm yok.
- Bu sistem bugün bir hastanın tedavisini etkiler mi?
- Hayır, hiçbir şekilde. Bu bir araştırma altyapısıdır; hedef seçimi ve çalışma tasarımı gibi ilaç geliştirme kararlarına yöneliktir, hasta bakımına değil. Hiçbir çıktısı bir tedavi önerisi niteliği taşımaz.
- Bu çalışmaya nasıl bakmalı — abartı mı, gerçek bir ilerleme mi?
- İkisi de değil, ikisi de biraz. Gerçek olan: 56 bin klinik çalışmayı okuyup etiketlemek, insan emeğiyle aylar sürecek bir iştir ve bu sistem bunu yapabildi; etiketleme isabeti de ölçülmüş ve iyi. Abartılan: bu taramadan çıkan gözlemsel ilişkinin nedensel bir keşif gibi sunulması, ve bilinen bir hedefi "önermenin" dış doğrulama sayılması. Çalışmanın asıl katkısı yeni bir biyolojik bilgi değil, ölçektir.
Terimler sözlüğü
- Yapay zekâ ajanı (AI agent)
- Bir görev üzerine akıl yürütebilen ve dış araçlara (veri tabanları, analiz yazılımları) bağlanarak eyleme geçebilen otonom sistem.
- Çok ajanlı sistem
- Birden fazla ajanın farklı roller üstlenip birbiriyle iletişim kurarak bir görevi birlikte yürütmesi. Virtual Biotech'te bu, bir şirketin bölümlerine benzetilerek kurulmuştur.
- Hücre tipine özgülük (tau indeksi)
- Bir genin vücutta her yerde mi yoksa yalnız belirli hücre tiplerinde mi çalıştığını ölçen sayı. 1'e yaklaştıkça özgüllük artar.
- Anahtar benzeri ifade (bimodalite)
- Bir genin kademeli olarak değil, "açık–kapalı" biçiminde iki uçlu çalışması. Genin ifade dağılımının şeklinden hesaplanır.
- Olasılık oranı (OR)
- İki grubu karşılaştıran sayı. 1,00 "fark yok" demektir; 1,27 ilgili olayın olasılığının arttığını gösterir. Güven aralığıyla birlikte okunmalıdır.
- Güven aralığı
- Gerçek etkinin makul olarak nerede olabileceğini gösteren sayı bandı. Bir etki büyüklüğü güven aralığı olmadan verildiğinde, ne kadar kesin ölçüldüğü bilinemez.
- Karıştırıcı etken (confounder)
- Hem incelenen faktörle hem de sonuçla ilişkili olan ve aradaki ilişkiyi yanıltıcı hale getirebilen üçüncü bir değişken. Burada en kritik adaylar tedavi alanı ve sponsor tipidir.
- Ters nedensellik
- İlişkinin varsayılanın tersi yönde işlemesi. Burada: genin özgüllüğünün başarıyı getirmesi yerine, başarının o genin özgüllüğünün bilinmesini sağlaması.
- Göreli ve mutlak etki
- "%48 daha olası" görelidir; "3 puan daha olası" mutlaktır. Aynı gerçeği anlatırlar ama farklı izlenim bırakırlar. Bir etkiyi değerlendirirken mutlak karşılığını bilmek şarttır.
- Prospektif doğrulama
- Bir tahminin, sonucu henüz bilinmezken yapılıp sonradan sınanması. Sonucu bilinen bir olayı açıklamak (retrospektif) çok daha kolaydır ve aynı kanıt değerini taşımaz.
- Bilgi kesim tarihi (knowledge cutoff)
- Bir dil modelinin eğitim verisinin bittiği tarih. Bu tarihten sonraki olayları "bilmemesi" beklenir — ama bir alanın hareketliliğine dair sinyaller eğitim verisinde bulunabileceği için, bu argüman tek başına öngörü kanıtı sayılmaz.
- B7-H3 (CD276)
- Birçok tümör hücresinin yüzeyinde yoğun bulunan, sağlıklı dokularda görece az ifade edilen bir protein. Kendi başına bir sinyal yolağı değildir; değeri antikor-ilaç konjugatları için bir adres olmasındadır.
- Antikor-ilaç konjugatı (ADC)
- Bir antikorun ucuna kimyasal bağlayıcıyla kemoterapi molekülü takılmış yapı. Antikor adres bulur, yük tümör hücresinin içinde serbest kalır.
- Faz I / II / III / IV
- Klinik araştırmanın aşamaları: güvenlilik ve doz (I), etkinlik sinyali (II), büyük randomize karşılaştırma (III), onay sonrası izlem (IV).
- Yararsızlık analizi (futility analysis)
- Çalışma sürerken yapılan ve "bu gidişle olumlu sonuç çıkma olasılığı çok düşük" denirse çalışmanın erken sonlandırılmasını sağlayan ara değerlendirme.
DROZDOGAN Akademi Yorumu
Bu çalışma iki ayrı şey yapıyor ve ikisini birbirinden ayırmak, yazıyı doğru okumanın anahtarı: bir altyapı kuruyor ve bir bulgu bildiriyor. Altyapı etkileyici; bulgu ise göründüğünden zayıf.
⚡ Bu çalışma neden konuşuluyor
Ölçek yüzünden. 55.984 klinik çalışmayı tek tek okuyup sonuçlarını etiketlemek, insan emeğiyle aylar sürecek bir iştir — ve bugüne kadar bu tür sorular hep küçük örneklemlerle sorulmuştu. Üstelik sistemin mimarisi de fikir olarak zarif: gerçek bir ilaç şirketinin bölümlerini taklit eden, birbirini denetleyen uzman ajanlar. Kod açık kaynak, veri kaynakları açık. Bu tarafı ciddiye alınmayı hak ediyor.
✅ Güçlü olan taraf
Etiketleme isabeti gerçekten ölçülmüş ve iyi: 100 çalışmanın elle denetiminde birincil sonlanımlarda %89,7, yan etki oranlarında %92,4; ayrı bir veri tabanıyla 7.278 çalışmada %85,3 uyum. Bu, "yapay zekâ okudu" demekle yetinmeyip sonucu sınamak demektir ve bu tür çalışmalarda sık görülmez. Ülseratif kolit analizindeki bulgu da ilgi çekici: üç farklı biyolojik ilaç sınıfında yanıt vermeyenlerin OSMR düzeyinin tutarlı biçimde yüksek çıkması, rastlantıyla açıklaması zor bir örüntüdür.
⚠️ Sınırlar ve dikkat edilmesi gerekenler
Manşet bulgu gözlemseldir ve karıştırıcı etkenler tam denetlenmemiştir: tedavi alanı yalnız rastgele etki olarak modele girmiş, onkolojiye özgü bir duyarlılık analizi yapılmamış, sponsor tipi hiç düzeltilmemiştir. Ters nedensellik ihtimali hiç tartışılmamıştır — oysa iyi çalışılmış hedeflerin hem daha iyi karakterize edilmesi hem de daha başarılı olması beklenir. Manşet olan iki sayının (%48 ve %32) güven aralığı yoktur; ve Faz I→II için olasılık oranı 1,27 iken metinde "%40 daha olası" denmesi kendi içinde tutarsızdır. Akciğer kanseri "doğrulaması" prospektif değildir ve ekip bunu kendisi kabul etmektedir. Sistem hiçbir deneysel sınamadan geçmemiştir. Ve dolaşan "5 günde" ifadesinin kaynağı yoktur — makale süre bildirmemektedir.
🩺 Pratikte ne yapılmalı
1. Bu çalışmanın hiçbir klinik karşılığı yoktur; bir hastaya anlatırken bunu açıkça belirtin.
2. "%48 daha başarılı" gibi göreli sayılar gördüğünüzde mutlak karşılığını sorun; burada karşılığı yaklaşık 3–6 puandır.
3. Bir etki büyüklüğü güven aralığı olmadan verilmişse, o sayıya temkinli yaklaşın.
4. "Yapay zekâ şu hedefi önerdi ve sonradan doğru çıktı" tipi haberlerde iki soruyu sorun: öngörü sonuç bilinmeden mi yapıldı, ve önerilen şey alanın zaten beklediği cevap mıydı?
5. Gözlemsel bir ilişkide her zaman şunu sorun: bu ilişki ters yönde de işleyebilir mi?
6. Ölçek etkileyicidir ama ölçek tek başına kanıt değildir — 56 bin çalışmadan çıkarılan yanlı bir ilişki, 56 kat daha güvenilir olmaz.
❓ Henüz cevabı olmayan sorular
Bu ilişki onkoloji dışlandığında da duruyor mu? Hedefin ne kadar çalışıldığı modele katılsa etki kalır mı? Sistem, sonucu henüz bilinmeyen çalışmalar için tahmin yapsa kaçı tutar — asıl sınav budur ve yapılmamıştır. On bir ajanlık zincirde bir hata ne sıklıkla üst basamaklarda düzeltiliyor, ne sıklıkla meşrulaşıyor? Ve daha genel bir soru: bu tür sistemler yaygınlaştıkça, literatürde zaten baskın olan hedeflerin daha da öne çıkması ve az çalışılmış alanların daha da geride kalması riski var mı? Yazarların kendi uyarısı bu soruyu davet ediyor: sistem "az çalışılmış hastalıklar ve hedefler için henüz uygun değildir".
Kısa hükmümüz: Virtual Biotech'in gerçek katkısı bir biyolojik keşif değil, bir ölçek gösterimidir — 56 bin klinik çalışmayı okuyup ölçülebilir isabetle etiketleyebilmek gerçek bir kazanımdır. Buna karşılık manşet olan bulgu, karıştırıcı etkenleri tam denetlenmemiş ve güven aralığı bildirilmemiş gözlemsel bir ilişkidir; akciğer kanseri "doğrulaması" ise geriye dönüktür. Aracın vaadi büyük, kanıtı henüz küçüktür — ve bu ikisini karıştırmamak, tam da bu tür araçların bize öğretmesi gereken disiplindir.
Şeffaflık notu. Science'ta yayımlanan makalenin tam metni ödeme duvarı arkasındadır ve erişilememiştir. Mimari, sayısal sonuçlar, vaka çalışmaları ve doğrulama ayrıntılarına ilişkin tüm bilgiler, aynı çalışmanın Şubat 2026 tarihli açık erişimli ön baskısından (bioRxiv) ve projenin açık kaynak kod deposundan alınmıştır. Ön baskı hakem değerlendirmesinden geçip revize edilerek yayımlandığı için yayımlanmış sürümdeki sayılar ve ifadeler farklılaşmış olabilir. Özetteki bilgiler (55.984 çalışma, 37.000'den fazla ajan, %48 ve %32) yayımlanmış sürümle uyumludur. Ek yöntemler bölümüne erişilemediği için hücre tipine özgülük ve anahtar benzeri ifade ölçütlerinin sayısal eşikleri bu yazıda verilememiştir.
Doğrulanamayanlar: Analizin süresi ve maliyeti (makale bildirmiyor; dolaşan "5 gün" ifadesinin kaynağı bulunamamıştır); %48 ve %32 için olasılık oranı ve güven aralıkları; OR 1,27 ile "%40 daha olası" ifadesi arasındaki tutarsızlığın nedeni; sponsor tipinin modele katılıp katılmadığı (karıştırıcı olarak sayılmış ama tanımlanan modellerde yer almıyor); onkolojiye özgü ya da tedavi alanına göre tabakalandırılmış bir duyarlılık analizinin yapılıp yapılmadığı; hangi Claude modelinin kullanıldığı (makale "Claude" diyor ve Ocak 2025 bilgi kesimi belirtiyor, kod deposu ise daha yeni bir model gösteriyor); elle denetimde birden fazla değerlendirici kullanılıp kullanılmadığı ve şansa göre düzeltilmiş uyum istatistiği.
Eleştiriler kime ait? Analizin gözlemsel olduğu, hata yayılımı riski, sistemin az çalışılmış hedefler için uygun olmadığı ve sonuçların deneysel doğrulama gerektirdiği yazarların kendi ifadeleridir. Akciğer kanseri örneğinin prospektif bir öngörü olmadığı da ekip tarafından kabul edilmiştir. Buna karşılık ters nedensellik ihtimali, tedavi alanının yalnız rastgele etki olarak modellenmesinin yetersizliği, göreli etkinin mutlak karşılığına çevrilmesi, bilgi kesimi argümanının öngörü kanıtı sayılamayacağı ve ham uyum oranının kappa olmadan yorumlanmasının sorunları başlıklarındaki eleştiriler bize aittir.
Mutlak etki hesapları (yaklaşık 3–6 puan) bize ait kaba çevirilerdir; makalede yer almamaktadır ve yayımlanmış temel geçiş oranlarına dayanmaktadır. Bu yazının hazırlandığı tarihte makale yayımlanalı iki gün olmuştu; Science'ta eşlik eden bir değerlendirme yazısı bulunmamakta ve adı belirtilmiş bir bilim insanından yayımlanmış eleştiri bulunmamaktadır.
Bu yazı bir araştırma altyapısını tanıtmaktadır. Anlatılan sistemin hiçbir klinik uygulaması yoktur, hasta bakımına dair bir öneri içermez ve hiçbir çıktısı tedavi önerisi niteliği taşımaz.
Kaynaklar
- Zhang HG, Eckmann P, Miao J, Mahon AB, Zou J. The Virtual Biotech: a multi-agent AI framework for therapeutic discovery and development. Science. 2026. DOI 10.1126/science.aeg6779.
- Aynı çalışmanın bioRxiv ön baskısı, Şubat 2026 (açık erişim); proje sayfası virtualbiotech.ai ve açık kaynak kod deposu.
- Miao J, Davis JR, Zhang Y, Pritchard JK, Zou J. Reimagining research papers as interactive and reliable AI agents. Nature. 2026. DOI 10.1038/s41586-026-11044-y.
- Stanford Medicine haber bülteni, 17 Eylül 2026.
- Nature haber servisi: "How a team of AIs discovered a promising lung-cancer drug." 2026.
- MOONGLOW çalışması (NCT06137183): viksarelimab, ülseratif kolit. Ağustos 2025'te sonlandırıldı.
- Thomas DW, ve ark. Clinical development success rates. BIO / Biomedtracker / Amplion raporu.
- Tabula Sapiens ve CELLxGENE Census tek hücre veri kaynakları.
- WCLC 2026: ARTEMIS-008 ve TAISHAN-302 çalışmaları — nükseden küçük hücreli akciğer kanserinde B7-H3 hedefli antikor-ilaç konjugatları.